MacBook Pro M5 Max 128 Go : les vraies mesures en IA locale (benchmark 2026)
Un MacBook Pro M5 Max 40 cœurs GPU avec 128 Go de mémoire unifiée, un protocole écrit à l'avance, six modèles, un document de 16 689 tokens : voici les premiers relevés publics en français sur le plus gros portable Apple en IA locale. Les mesures ont été réalisées par Joël Ramat, consultant cybersécurité et GRC, sur sa propre machine, à notre demande et selon notre protocole. Tous les chiffres sont les sorties brutes d'Ollama, sans retouche.
#La machine et le protocole
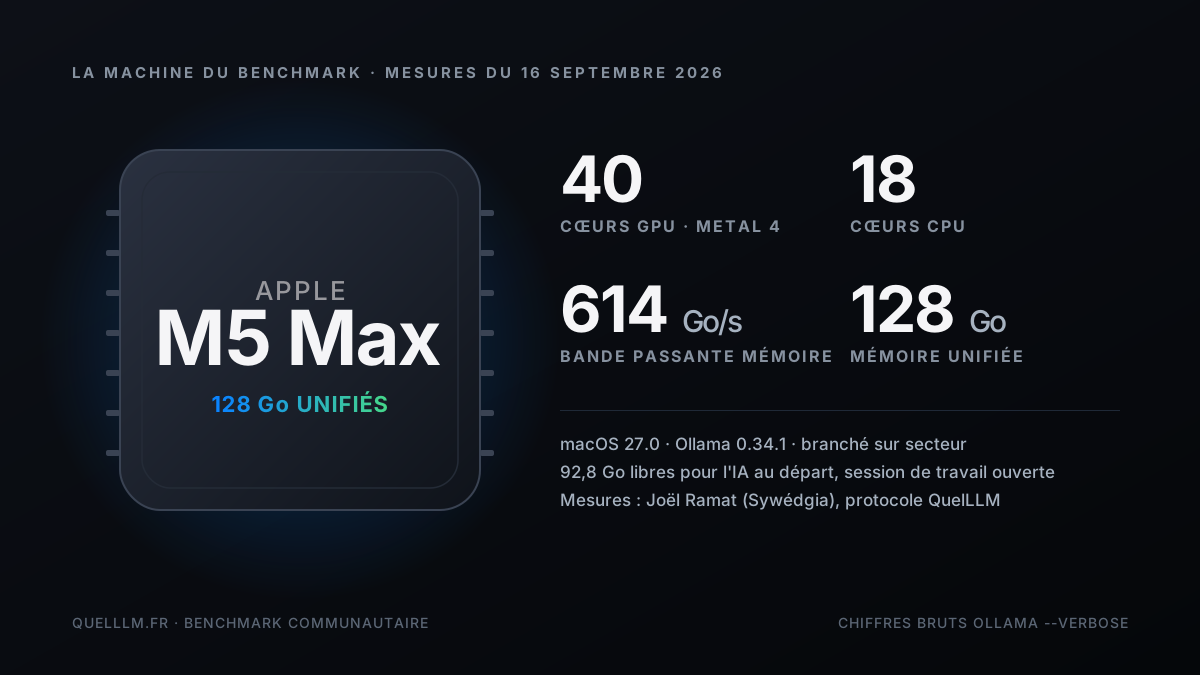
La machine est un MacBook Pro 16 pouces avec la puce M5 Max complète : 18 cœurs CPU, 40 cœurs GPU, 128 Go de mémoire unifiée annoncés à 614 Go/s. Elle tourne sous macOS 27.0 avec Ollama 0.34.1. Aucun paramètre système n'a été modifié : la limite mémoire GPU est celle par défaut, ce qui compte pour comparer avec votre propre Mac.
Le protocole tient en quatre règles, et elles ne sont pas décoratives. Mac branché sur secteur, parce que macOS bride la puce sur batterie. Applications lourdes fermées. Un seul modèle chargé à la fois. Et surtout le même prompt pour toutes les séries, celui qui rend les chiffres comparables entre modèles et, demain, entre machines.
- Série A, les deux repères
- Gemma 4 12B et Qwen 3.8 27B en GGUF, deux modèles qui tournent aussi sur des Mac bien plus modestes. Ils situent la machine sur une échelle connue.
- Série B, MLX contre GGUF
- Le même Qwen 3.8 27B, même poids, servi par le moteur MLX d'Ollama au lieu de llama.cpp. Seul le moteur change.
- Série C, le vrai sujet du palier 128 Go
- gpt-oss 120B, 65 Go, un modèle qui n'entre tout simplement pas dans un portable PC.
- Série D, le préfill sur charge réelle
- Un document de 16 689 tokens envoyé d'un bloc à gpt-oss 120B, avec une consigne de synthèse. C'est le seul relevé de préfill significatif de la campagne.
- Deux bonus hors protocole
- Joël avait déjà Qwen 3.6 35B-A3B en MLX et gpt-oss 20B sur sa machine. Il les a mesurés dans les mêmes conditions.
#Tous les chiffres en un tableau
L'IA locale sur ton Mac, à fond : mémoire unifiée, MLX vs GGUF, le bon modèle pour ta puce, Ollama et LM Studio réglés pour Apple Silicon.
- Espace en ligne à vie
- PDF + fichiers
- Remboursé 30 j
Voici les sorties brutes de la commande ollama run --verbose, telles que Joël les a copiées après chaque mesure. Chaque modèle a produit une réponse complète au prompt de 300 mots, en mode raisonnement quand le modèle en dispose, ce qui explique les 1 400 à 3 200 tokens générés pour 300 mots de texte final.
| Modèle | Moteur | Poids | Génération | Tokens produits | Durée totale |
|---|---|---|---|---|---|
| Gemma 4 12B | GGUF Q4 | 7,6 Go | 58,1 tok/s | 1 390 | 24 s |
| Qwen 3.8 27B | GGUF Q4 | 17 Go | 36,6 tok/s | 2 517 | 69 s |
| Qwen 3.8 27B | MLX | 18 Go | 68,0 tok/s | 2 103 | 31 s |
| Qwen 3.6 35B-A3B (bonus) | MLX | 23 Go | 167,2 tok/s | 3 205 | 19 s |
| gpt-oss 20B (bonus) | MXFP4 | 13 Go | 113,4 tok/s | 2 199 | 19 s |
| gpt-oss 120B | MXFP4 | 65 Go | 79,1 tok/s | 669 | 8,5 s |
| gpt-oss 120B, relance 1 | MXFP4 | 65 Go | 77,5 tok/s | 732 | 12,5 s |
| gpt-oss 120B, relance 2 | MXFP4 | 65 Go | 75,5 tok/s | 1 707 | 22,7 s |
| gpt-oss 120B, série D | MXFP4 | 65 Go | 67,6 tok/s | 2 584 | 50 s |
| Série | Tokens de prompt | Préfill | Temps avant le premier mot |
|---|---|---|---|
| A, B, C (prompt court) | 43 à 98 | 31 à 346 tok/s | 0,1 à 0,9 s : latence de démarrage, pas un débit |
| D, document de 16 689 tokens | 16 689 | 1 388 tok/s | 12,0 s |
#Génération : six modèles, une lecture
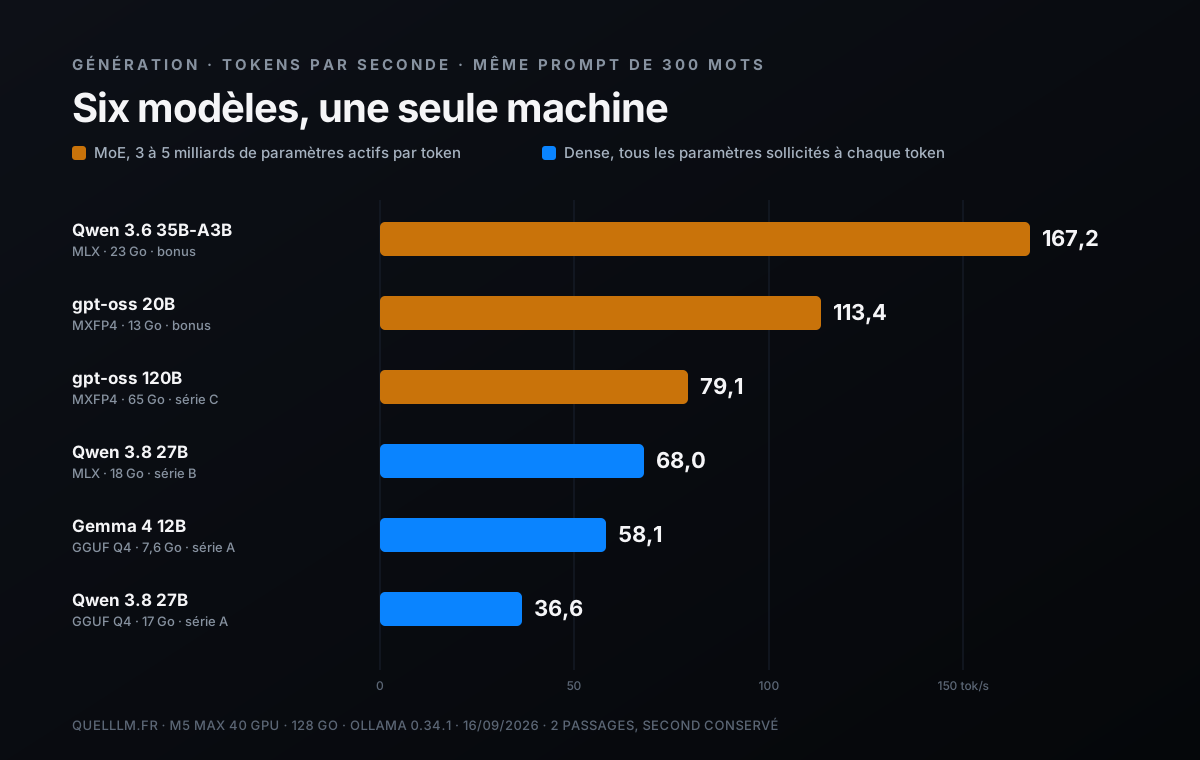
Lu naïvement, ce classement est absurde : un modèle de 120 milliards de paramètres à 79 tokens par seconde, deux fois plus rapide qu'un 27B en GGUF. L'explication tient en trois lettres. gpt-oss 120B, gpt-oss 20B et Qwen 3.6 35B-A3B sont des modèles à mélange d'experts, MoE. À chaque token, seule une fraction des paramètres est sollicitée : environ 5 milliards pour gpt-oss 120B, 3,6 milliards pour gpt-oss 20B, 3 milliards pour le Qwen. La vitesse de génération dépend de ce qui bouge en mémoire à chaque token, pas de ce qui y dort.
Les modèles denses, Gemma 4 12B et Qwen 3.8 27B, sollicitent tous leurs paramètres à chaque token. Leur vitesse suit donc la bande passante mémoire divisée par le poids du modèle : c'est la règle des Mac depuis le M1, et le M5 Max ne s'en affranchit pas. Sur cette machine, un 27B dense en GGUF tourne à 37 tokens par seconde, un 12B à 58.
- 167 tok/s sur Qwen 3.6 35B-A3B en MLX
- Le chiffre le plus élevé de la campagne, sur le modèle qui combine les deux accélérateurs : architecture MoE et moteur MLX. C'est la vitesse d'un petit 8B, avec la culture d'un 35B.
- 113 tok/s sur gpt-oss 20B
- Le meilleur rapport vitesse, qualité et poids pour un usage quotidien de type assistant : 13 Go, une réponse de 2 200 tokens en 19 secondes.
- 79 tok/s sur gpt-oss 120B
- Le modèle le plus capable de la liste, à une vitesse deux fois supérieure à la lecture humaine. C'est le résultat qui justifie le palier 128 Go, on y revient plus bas.
- 58 et 37 tok/s sur les denses
- Gemma 4 12B et Qwen 3.8 27B en GGUF : confortable, mais sans surprise. Ce sont les mêmes ordres de grandeur que sur un M4 Max, la bande passante ayant peu bougé entre les deux générations.
#MLX contre GGUF, à conditions égales
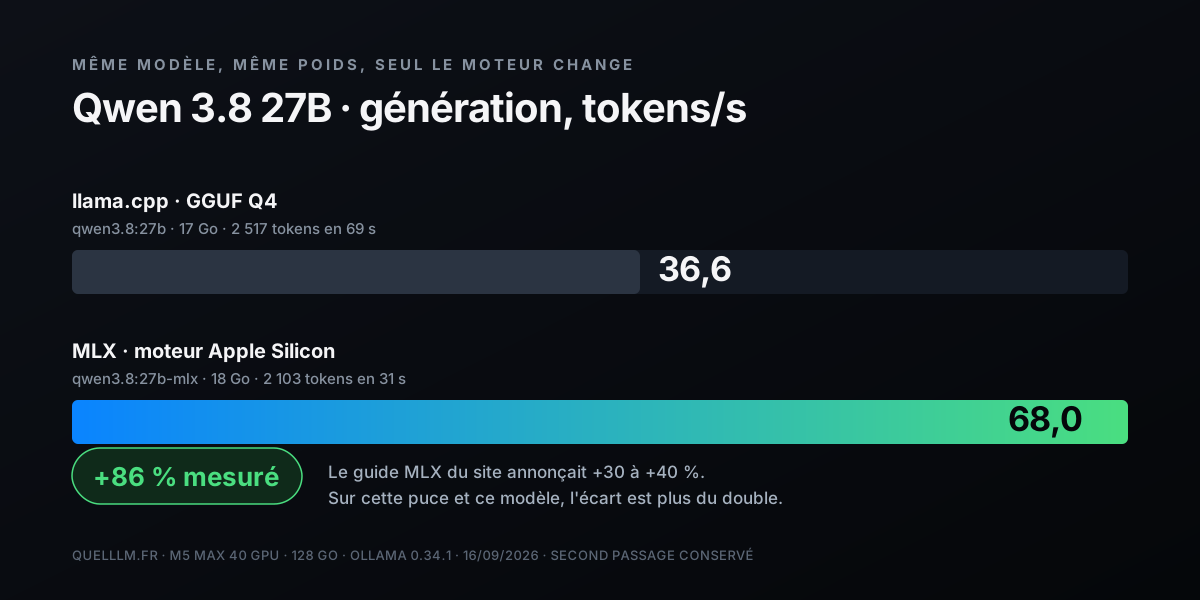
Tout le monde affirme que MLX, la bibliothèque d'Apple optimisée pour Apple Silicon, est plus rapide que llama.cpp. Très peu de gens le mesurent à conditions strictement égales, sur le même modèle, le même jour, la même machine. C'est ce que fait la série B : Qwen 3.8 27B en GGUF Q4 à 36,6 tokens par seconde, puis Qwen 3.8 27B en MLX à 68,0 tokens par seconde. Plus 86 %.
Notre guide sur MLX et le Mac M5 annonçait un gain de 30 à 40 % en génération. Sur le M5 Max et ce modèle, la réalité est plus du double. Une partie de l'écart vient sans doute des optimisations MLX propres à la génération M5 et des accélérateurs neuronaux intégrés au GPU ; nous ne pouvons pas encore isoler leur contribution. Ce que nous pouvons dire, c'est que sur un Mac récent, tourner un modèle dense en GGUF alors que sa version MLX existe revient à laisser la moitié de la machine au garage.
#Ce que 128 Go achètent réellement
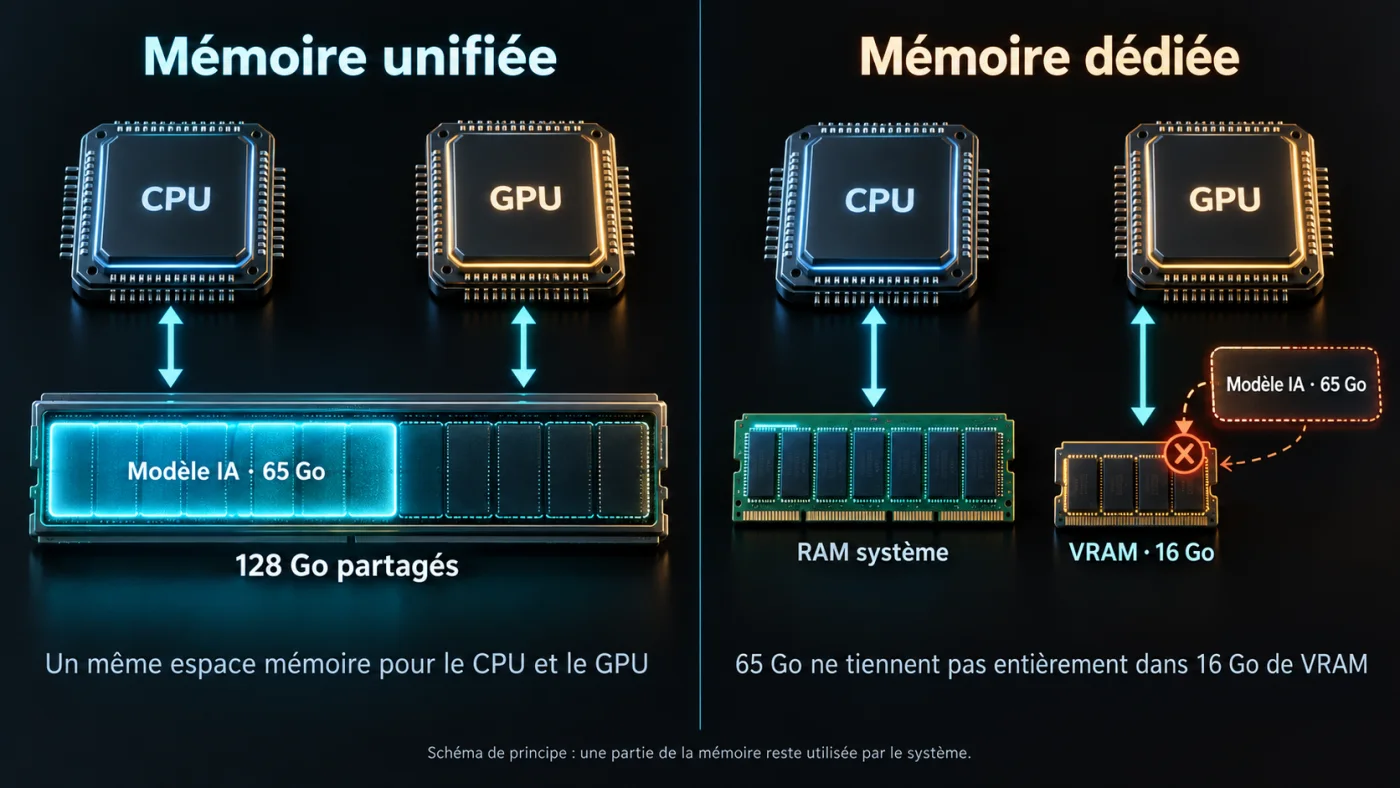
Le vrai sujet du palier 128 Go n'est pas la vitesse, c'est ce qui rentre. gpt-oss 120B pèse 65 Go en MXFP4. Aucun portable PC ne le fait tourner sur GPU : les cartes mobiles plafonnent à 16 ou 24 Go de VRAM. Sur le M5 Max 128 Go, il se charge, répond entre 75 et 79 tokens par seconde sur trois exécutions, et il reste de la place.
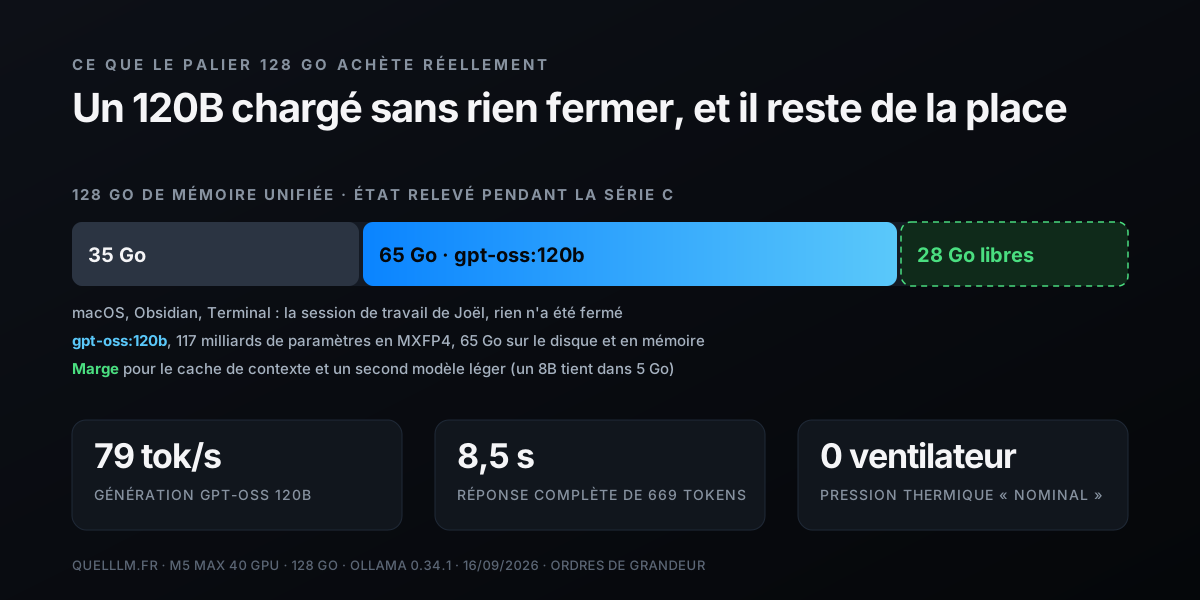
Le relevé mémoire fait avant la campagne est parlant : 35 Go occupés par macOS et les applications de la session de travail, 93 Go disponibles pour l'IA. Le 120B s'y installe avec une marge d'une trentaine de gigaoctets, de quoi tenir un contexte long et un second modèle léger en parallèle, un 8B pour l'autocomplétion de code par exemple. Sur un M5 Max 64 Go, le même modèle ne se charge pas du tout ; sur 96 Go il passe, mais sans marge pour le reste.
- 8,5 à 22,7 secondes
- Durée totale de la réponse de gpt-oss 120B au prompt de 300 mots, sur trois exécutions : 669, 732 puis 1 707 tokens produits. La vitesse ne bouge pas (79,1, 77,5 et 75,5 tokens par seconde), c'est la longueur du raisonnement qui varie d'une exécution à l'autre, le modèle décidant ou non de compter ses mots un par un.
- 50 secondes
- Durée de la série D : lecture d'un document de 16 689 tokens puis rédaction d'une synthèse en dix puces de 2 584 tokens.
- Pression thermique « Nominal »
- Relevé après chaque série. Aucun ventilateur audible sur l'ensemble de la campagne, 120B compris.
#Le préfill, le chiffre que personne ne publie
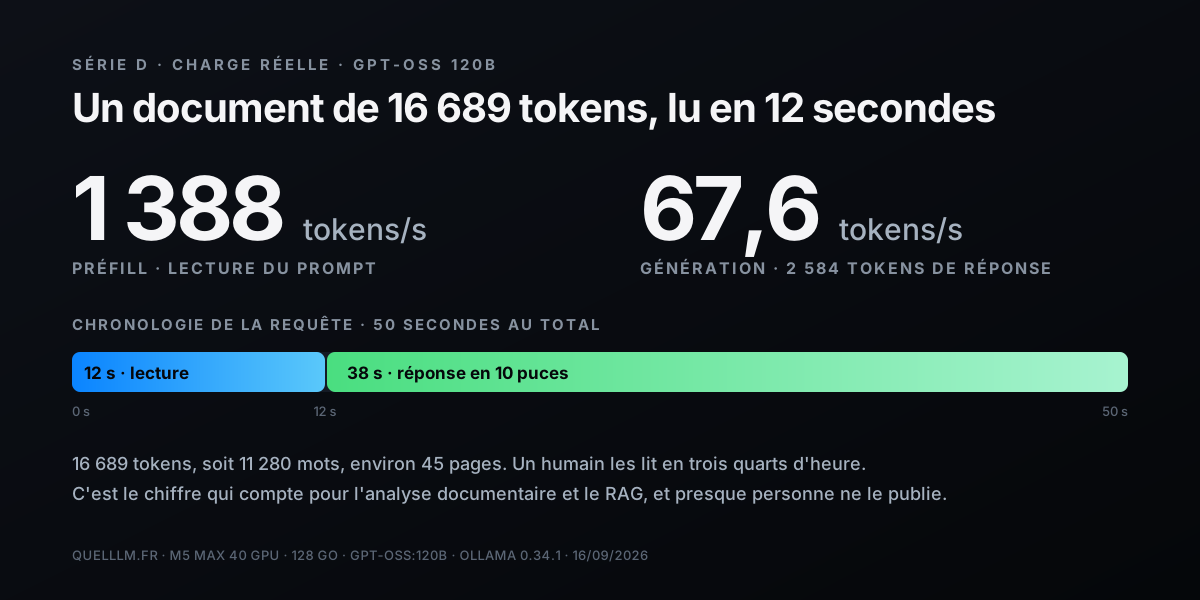
Un prompt de vingt mots ne dit rien du préfill. Pour le mesurer, Joël a envoyé à gpt-oss 120B un texte de 11 280 mots en un seul bloc, soit 16 689 tokens et environ 45 pages, avec une consigne de récapitulatif. Résultat : 1 388 tokens par seconde en lecture, soit douze secondes avant que le premier mot de la réponse n'apparaisse, puis 2 584 tokens de synthèse à 67,6 tokens par seconde.
C'est le chiffre qui parle aux usages sérieux. Analyser un contrat, résumer un rapport d'audit, interroger une base documentaire en RAG : dans tous ces cas, le modèle passe l'essentiel de son temps à lire, pas à écrire. Douze secondes pour 45 pages, sur un portable, sans qu'un octet ne quitte la machine, c'est ce qui rend l'IA locale utilisable pour un consultant soumis au secret professionnel ou une entreprise sous contrainte de confidentialité.
#Chaleur et ventilateurs
Joël a noté l'état thermique après chaque série avec la commande de pression thermique de macOS. Verdict constant : « Nominal », et aucune ventilation audible, y compris pendant la série D qui sollicite le GPU à plein pendant cinquante secondes. C'est cohérent avec ce qu'on observe sur les M4 Max, avec une réserve : nos mesures sont des rafales de moins d'une minute. Le test de throttling prévu au protocole, dix minutes de charge continue puis nouvelle mesure de la série A, n'a pas été réalisé. Nous le demanderons lors de la prochaine campagne.
#Ce que ces mesures ne disent pas
Un benchmark honnête liste ce qu'il ne prouve pas. Voici les réserves, dans l'ordre d'importance.
- Préfills des prompts courts
- Deux passages par modèle, second conservé. Mais 43 à 98 tokens de prompt ne mesurent qu'une latence de démarrage : seule la série D, sur 16 689 tokens, donne un vrai débit de lecture.
- Aucun modèle dense de 70 milliards
- Le palier 128 Go se justifie aussi par les 70B en Q4 avec un long contexte. Non mesuré ici.
- Pas de test de throttling
- Rafales de moins d'une minute. Le comportement sur une heure de RAG intensif reste à documenter.
- Pas de mesure sur batterie
- Le protocole impose le secteur. Sur batterie, attendez-vous à des chiffres sensiblement inférieurs, macOS bridant la puce.
- Un document de série D propre à chaque testeur
- Le texte long envoyé en série D n'est pas imposé par le protocole : deux testeurs ne lisent pas le même document, ce qui limite la comparaison des préfills entre machines. Sur une suggestion de Joël, le protocole fournit désormais un texte de référence unique de 11 292 mots, à télécharger dans la section suivante : les prochains relevés seront comparables entre eux. Le relevé de cette page a été fait avant, sur un autre document de taille équivalente.
- Une seule machine, un seul opérateur
- Aucune variance mesurée. Si vous avez la même configuration, vos relevés sont bienvenus, voir la section suivante.
- Modèles en mode raisonnement
- Les modèles qui réfléchissent avant de répondre produisent beaucoup plus de tokens que les 300 mots demandés, et cette longueur varie d'une exécution à l'autre pour un même modèle (669 à 1 707 tokens sur gpt-oss 120B). Les durées totales ne sont donc pas comparables, seules les vitesses le sont.
- Cache de prompt sur les relances
- Quand le même prompt est relancé, Ollama réutilise les tokens déjà lus (« prompt eval cached »). Le préfill d'une relance à l'identique n'est donc pas une mesure ; pour mesurer le préfill, il faut un prompt long et nouveau, comme en série D.
#Reproduire le benchmark chez vous
Le protocole est conçu pour être rejoué tel quel sur n'importe quel Mac Apple Silicon, du MacBook Air au Mac Studio. Si vous suivez les mêmes séries avec le même prompt, vos chiffres sont directement comparables à ceux de cette page.
- 01Préparer la machine
- 02Relever l'état du système
- 03Série A
- 04Série B
- 05Série C
- 06Série D
#Pour qui, et à quel prix
Le M5 Max 128 Go se justifie par un seul usage : faire tourner en local des modèles qui ne rentrent nulle part ailleurs dans un portable, avec de la marge pour le contexte et un second modèle. gpt-oss 120B à 79 tokens par seconde et un document de 45 pages lu en douze secondes, sans ventilateur, c'est une station de travail IA qui tient dans un sac.
| Vous êtes | Ce que ce benchmark vous dit | Palier conseillé |
|---|---|---|
| Consultant, avocat, expert-comptable sous secret professionnel | Un 120B lit et synthétise vos dossiers en local, à une vitesse utilisable, sans rien envoyer dehors | M5 Max 128 Go |
| Développeur qui veut un copilote local sérieux | gpt-oss 20B ou Qwen 3.6 35B-A3B suffisent largement et tiennent dans 48 Go. Nos 113 et 167 tok/s valent pour la puce 40 cœurs GPU : la mémoire suffit, la vitesse sera inférieure sur une variante à bande passante plus faible | M5 Max 48 ou 64 Go |
| Utilisateur quotidien d'un assistant de rédaction | Un 12B dense ou un MoE 20B couvrent l'usage ; le 128 Go est un luxe. La mémoire suffit, mais celle du M5 Pro est plus lente : comptez moins que nos 58 et 113 tok/s | M5 Pro 48 Go |
| Équipe qui veut un serveur partagé | Le Mac Studio M5 Max ou Ultra offre le même moteur avec plus de mémoire et un refroidissement de bureau | Mac Studio |
Si votre besoin s'arrête aux modèles de 30 milliards de paramètres, la moitié de la mémoire suffit et l'écart de prix finance un très bon écran. Si votre besoin commence aux modèles de 100 milliards, il n'existe pas d'alternative portable, et ce guide vous donne les chiffres pour le justifier devant qui signe le bon de commande.
#Crédits et sources
Les mesures de cette page ont été réalisées par Joël Ramat, consultant cybersécurité et GRC, expert ISO 27001, conseil et audit augmentés par l'IA on-premise, cofondateur et président de Sywédgia SAS. Il a exécuté le protocole QuelLLM sur sa propre machine le 16 septembre 2026, et a relu cet article avant publication. Les relevés restent les siens et il est libre de les publier de son côté.
- Joël Ramat sur LinkedIn
- Sywédgia, conseil et audit cybersécurité
- Notre guide MLX contre llama.cpp sur Mac M5
- Fiche matériel MacBook Pro M5 Max
- Installer gpt-oss avec Ollama
Méthode : sorties brutes de ollama run --verbose copiées après chaque mesure, sans retouche ; état système relevé par script avant la campagne ; pression thermique lue après chaque série. Le rapport complet, avec les réponses intégrales des modèles, est conservé et peut être communiqué sur demande. Rédaction et mise en forme : Mohamed Meguedmi, QuelLLM.fr.
#FAQ
Le M5 Max 128 Go est-il plus rapide que le M4 Max 128 Go en IA locale ?+
Pourquoi gpt-oss 120B est-il plus rapide que Qwen 3.8 27B ?+
Faut-il 128 Go pour faire tourner gpt-oss 120B ?+
Ces chiffres valent-ils sur batterie ?+
Pourquoi les préfills des séries A, B et C ne sont-ils pas publiés ?+
Puis-je envoyer mes propres mesures ?+
Où trouver le script de préparation utilisé pour ce benchmark ?+
Un retour, une erreur, une précision ? Faites-nous signe, ça améliore le guide pour tout le monde.