GIGABYTE AI TOP ATOM : la GB10 128 Go mesurée en détail
Le mini-PC IA de GIGABYTE : puce NVIDIA GB10 et 128 Go de mémoire unifiée dans un litre. On regarde ce qui compte pour faire tourner des LLM en local : mémoire, bande passante, vitesse, prix — et pour qui c'est (ou non) le bon achat.
Mis à jour le 08/10/2026
Où l'acheter
La configuration du bouton est celle proposée à l’achat. Sur mini-PC, gardez de la mémoire pour le système et vérifiez le moteur d’inférence ; macOS/MLX et CUDA ne sont pas interchangeables.
Liens affiliés — QuelLLM peut percevoir une commission sur les achats, sans surcoût pour vous, ce qui n'influence pas ces recommandations (établies de façon indépendante). En tant que Partenaire Amazon, QuelLLM réalise un bénéfice sur les achats remplissant les conditions requises.
Fiche technique
- Mémoire128 Go unifiés (LPDDR5x), 121,7 Go vus par le système
- Bande passante273 Go/s
- CalculGPU Blackwell et 20 cœurs Arm ; jusqu'à 1 PFLOP en FP4 avec sparsité selon NVIDIA (annonce, non mesurée par nous)
- ConsoAdaptateur USB-C de 240 W ; GPU à 10,4 W au repos et de 39 à 53 W en moyenne en charge dans nos relevés (GPU seul, sans wattmètre)
- Prix indicatif6 346,27 € (ATAGB10-9001, 4 To PCIe 4.0, boutique officielle AORUS, épuisée ; en stock sur Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 To PCIe 5.0, LDLC et Materiel.net, en rupture) — relevé du 08/10/2026
- Plus gros modèleQwen3-235B-A22B en 3 bits (90,5 Go occupés, 21 Go de marge) · Llama 3.3 70B à environ 5 tokens par seconde, 2,6 à 4 fois plus vite avec un petit modèle brouillon · gpt-oss 120B à 58 tokens par seconde ; nos 13 modèles, du 4B au 235B, tiennent avec 32 768 tokens de contexte
Pour qui ?
Avantages et limites
✓ Points forts
- 128 Go de mémoire unifiée : nos 13 modèles, du 4B au 235B (en 3 bits), tiennent avec 32 768 tokens de contexte
- Les vitesses du DGX Spark de NVIDIA, à 4,3 % près au plus avec llama.cpp et à 2 % près avec Ollama
- Vitesse stable en charge continue : 0,0 % de dérive en 1 h à 16 utilisateurs, −0,6 % en 2 h à 8 utilisateurs, aucun bridage signalé
- SSD 4 To PCIe 5.0 sur l'ATAGB10-9000 : 13 Go/s en lecture
- Pile CUDA complète : llama.cpp, vLLM, TensorRT-LLM et Unsloth ont fonctionné chez nous
- Châssis d'un litre, 1,2 kg, façade épurée
✗ Limites
- Prix supérieur à un mini-PC Ryzen AI Max+ 395 de 128 Go
- Un modèle dense de 70B écrit à environ 5 tokens par seconde, limite de la bande passante de la plateforme GB10 (273 Go/s) : un modèle MoE ou un petit brouillon (×2,6 à ×4) donne des vitesses de conversation
Ce que nous avons mesuré
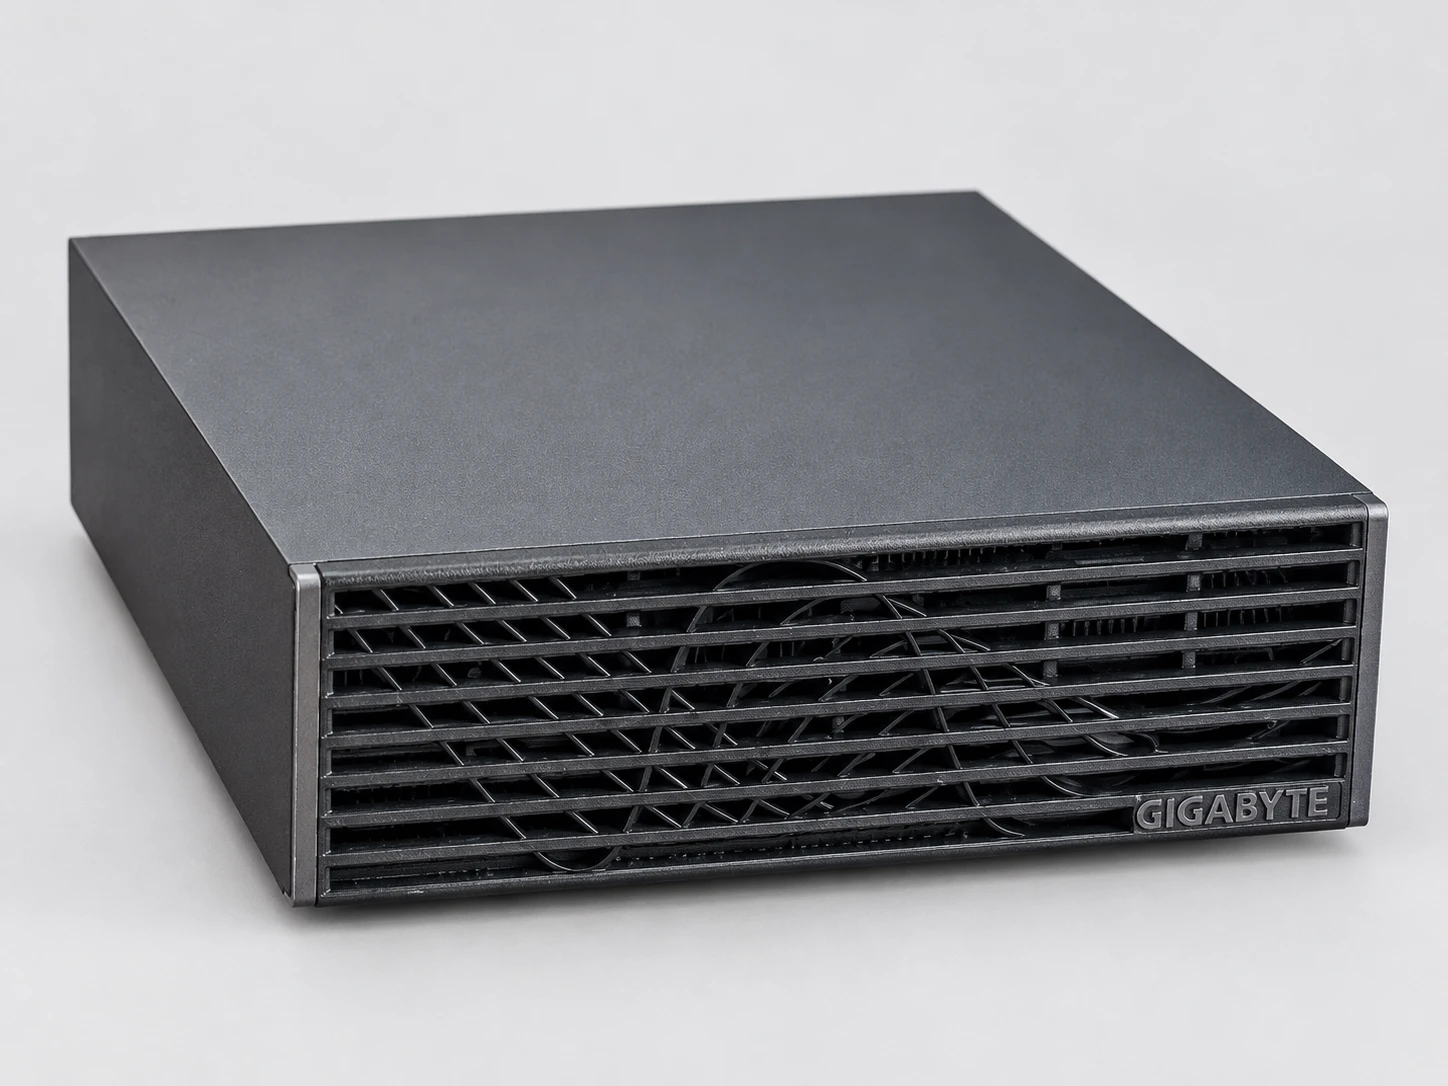
GIGABYTE nous a fourni gracieusement une AI TOP ATOM (ATAGB10-9000 : 128 Go, SSD 4 To PCIe 5.0) pour une série de guides. Les mesures et les avis sont les nôtres ; GIGABYTE n'a ni relu ni validé ce contenu avant sa publication. La méthode (protocole figé avant la première mesure), les empreintes des fichiers de modèles et les données de nos tableaux sont publiées sur notre page de méthode. Nos données, infographies et photos sont réutilisables sous licence CC BY 4.0, en citant quelllm.fr.
| Guide | Ce qu'il montre |
|---|---|
| Quels LLM tournent vraiment | 13 modèles du 4B au 235B : tous tiennent avec 32 768 tokens de contexte ; gpt-oss 120B à 58 tokens par seconde |
La série compte 7 guides, publiés un par semaine : cette page s'enrichit à chaque nouveau guide.
Les références AI TOP ATOM
GIGABYTE décline l'ATOM en six références, de ATAGB10-9000 à ATAGB10-9005. Les trois premières ont 128 Go : 9000 avec un SSD de 4 To en PCIe 5.0 (celle que nous avons mesurée), 9001 avec 4 To en PCIe 4.0, 9002 avec 1 To en PCIe 4.0. Une version 64 Go est annoncée à partir du 23 octobre 2026. Vérifiez la référence exacte chez le revendeur : certaines fiches décrivent mal le SSD.
Pour qui
- Une équipe de 5 à 20 personnes qui veut un assistant IA privé sur ses documents (mesuré jusqu'à 10 utilisateurs simultanés).
- Un développeur CUDA qui veut la pile NVIDIA complète sur son bureau.
- Le fine-tuning local : LoRA d'un Qwen3-8B, QLoRA d'un 70B et de gpt-oss 120B avec Unsloth.
- Les grands modèles MoE de plus de 100 milliards de paramètres, à vitesse confortable.
Verdict
Questions fréquentes
Le GIGABYTE AI TOP ATOM peut-il faire tourner un LLM 70B en local ?
Qwen3-235B-A22B en 3 bits (90,5 Go occupés, 21 Go de marge) · Llama 3.3 70B à environ 5 tokens par seconde, 2,6 à 4 fois plus vite avec un petit modèle brouillon · gpt-oss 120B à 58 tokens par seconde ; nos 13 modèles, du 4B au 235B, tiennent avec 32 768 tokens de contexte.
Combien coûte le GIGABYTE AI TOP ATOM ?
Compter 6 346,27 € (ATAGB10-9001, 4 To PCIe 4.0, boutique officielle AORUS, épuisée ; en stock sur Amazon.fr) · 7 999,95 € (ATAGB10-9000, 4 To PCIe 5.0, LDLC et Materiel.net, en rupture) — relevé du 08/10/2026 (Version 64 Go annoncée par NVIDIA à partir de 4 999 $ (États-Unis), disponible dès le 23/10/2026 ; GIGABYTE a confirmé une AI TOP ATOM 64 Go le 05/10/2026). Les prix varient vite — vérifiez le prix du jour via les liens d'achat.
Pour qui le GIGABYTE AI TOP ATOM est-il fait ?
Développeurs CUDA, équipes qui veulent un assistant IA privé, fine-tuning local, grands modèles MoE de plus de 100B.