GB10 128 Go : quels LLM tournent vraiment (mesures)
Sur une GIGABYTE AI TOP ATOM (NVIDIA GB10, 128 Go), les 13 modèles mesurés, du 4B au 235B, tiennent avec 32 768 tokens de contexte et au moins 20 Go de marge. Les grands modèles MoE, qui n'activent qu'une partie de leurs paramètres à chaque token, vont bien plus vite qu'un modèle dense de même taille : gpt-oss 120B écrit 58 tokens par seconde. Un 70B dense écrit à 4,8 tokens par seconde : c'est la bande passante mémoire, et non la place, qui fixe la vitesse.
Cent vingt-huit gigaoctets de mémoire unifiée : c'est l'atout des machines GB10 face aux cartes graphiques. Mais que peut-on vraiment y charger, avec quelle marge et à quelle vitesse ? Nous avons mesuré 13 modèles, du 4B au 235B, sur une AI TOP ATOM fournie gracieusement par GIGABYTE, avec un protocole figé avant la première mesure. Voici ce qui tient, ce qui est agréable au quotidien et pour qui c'est le bon achat.
#La machine testée
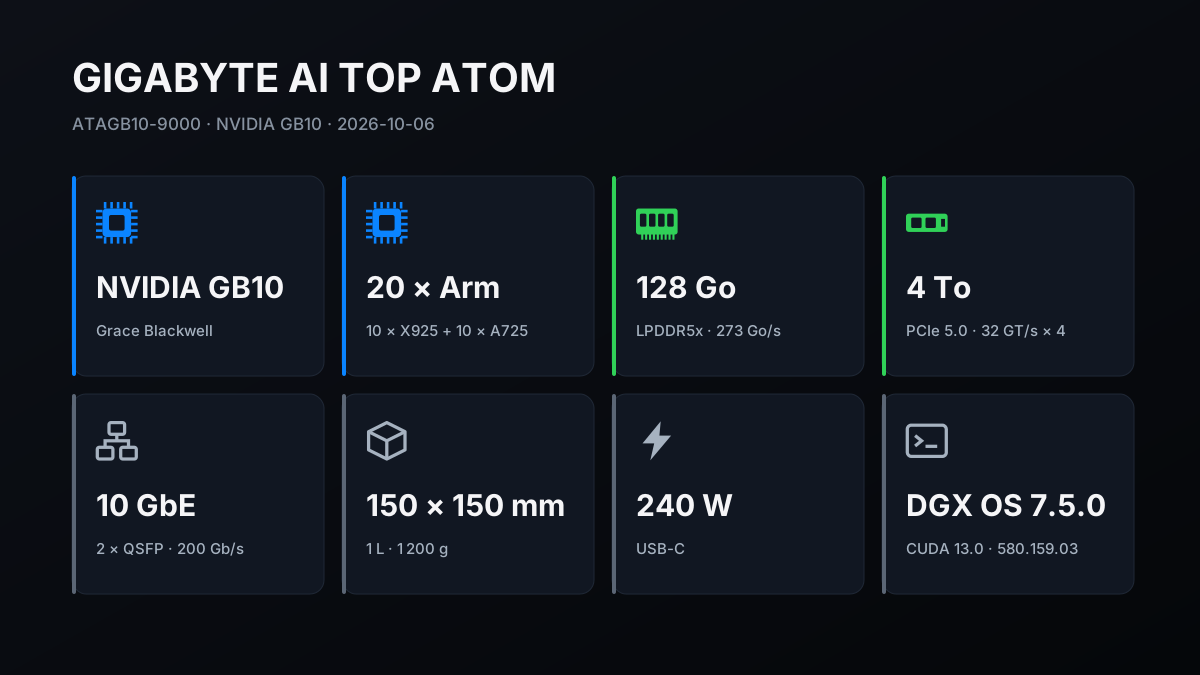
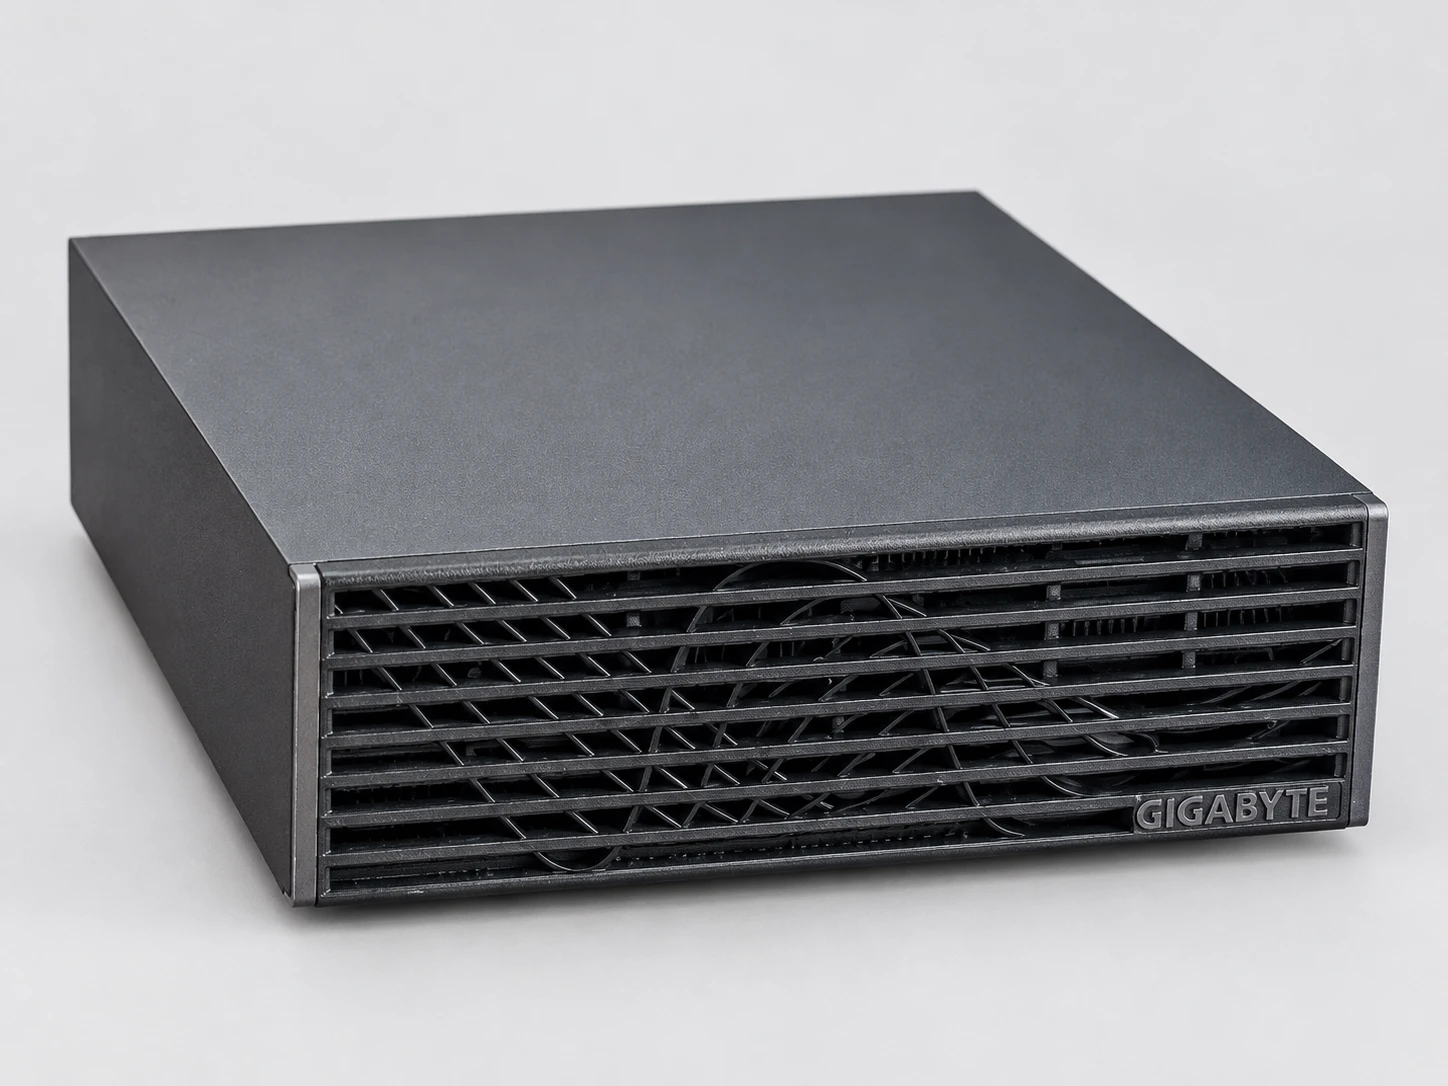
La machine est une GIGABYTE AI TOP ATOM, référence ATAGB10-9000 : puce NVIDIA GB10 (20 cœurs Arm et un GPU Blackwell partageant 128 Go de mémoire annoncée à 273 Go/s), SSD de 4 To en PCIe 5.0. Elle tourne sous DGX OS 7.5.0, le système de NVIDIA basé sur Ubuntu (pilote 580.159.03, CUDA 13.0).
Trois logiciels ont servi. llama.cpp, un moteur open source très répandu pour faire tourner les modèles en local, compilé sur place pour la puce GB10, donne le tableau principal. Ollama 0.34.1 sert à la comparaison avec un MacBook Pro M5 Max mesuré avec la même version. vLLM 26.09, un serveur conçu pour répondre à plusieurs personnes à la fois, tourne dans le conteneur fourni par NVIDIA.
#Comment nous avons mesuré
Les vitesses de llama.cpp viennent de cinq répétitions, avec un écart-type (la dispersion entre répétitions) d'au plus 3 %. Les temps de chargement, la lecture d'un document de 30 000 tokens et les marges de mémoire sont des mesures uniques ; les tests à plusieurs utilisateurs sont répétés trois fois. Avant la première mesure, un test de trois minutes a vérifié que le GPU tenait sa puissance de calcul.
Les fichiers des 13 modèles ont une empreinte SHA-256 (une signature numérique du fichier) identique à celle publiée par Hugging Face, le site qui héberge ces modèles. Le protocole, rédigé le 5 octobre, a été figé le 6 à 13 h 30, avant la première mesure.
Un avenant du même jour, vers 16 h 50, a avancé au soir la remesure à froid et ajouté des tests repris ici : script officiel d'Ollama, décodage spéculatif, charge continue et Llama 3.3 70B en NVFP4. La méthode, les empreintes des fichiers et les données de nos tableaux sont publiées sur notre page de méthode.
Les chiffres principaux ont été remesurés à froid le soir même, après 20 minutes de repos et cache vidé : au plus 2,6 % d'écart, sous le seuil de 3 % du protocole.
#La même vitesse qu'un DGX Spark, à quelques pour cent près
À notre connaissance, les machines GB10 de 128 Go partagent la même puce NVIDIA et la même mémoire ; leur construction, leur refroidissement et leur stockage peuvent différer. Pour situer l'ATOM, nous avons rejoué deux références publiées pour le DGX Spark de NVIDIA, avec la même version de logiciel et les mêmes réglages.
Avec llama.cpp (build 7941, celui du tableau publié par le projet ; notre tableau principal utilise le build 11430, plus récent), sur six modèles communs, la lecture est identique à 2,3 % près ; l'écriture est inférieure de 2,8 % en médiane et de 4,3 % au plus. Avec le script officiel d'Ollama (version 0.12.6, celle de ses mesures publiées), nos trois mesures sont à 2 % près, en lecture comme en écriture : gpt-oss 20B, gpt-oss 120B et Llama 3.1 70B.
Les vitesses de ce guide devraient donc valoir, à quelques pour cent près, pour les autres machines GB10 de 128 Go ; nous n'avons mesuré que l'ATOM. Sa construction et sa tenue en charge (températures, stabilité sur 1 h et 2 h) sont détaillées dans le guide suivant de la série, et sa consommation dans un guide dédié.
#13 modèles, du 4B au 235B : place occupée et vitesse
Le tableau résume la campagne. « Mémoire occupée » est la baisse de mémoire disponible une fois le modèle chargé avec 32 768 tokens de contexte réservés. « Chargement » est le temps de chargement à froid, cache disque vidé. Les vitesses viennent de l'outil de mesure llama-bench (llama.cpp, build 11430 du 5 octobre 2026), à contexte vide puis avec 32 768 tokens déjà présents ; les durées réelles pour un long document sont plus bas.
| Modèle | Type | Mémoire occupée | Chargement | Écriture (vide → 32k) | Lecture (vide → 32k) | Usage |
|---|---|---|---|---|---|---|
| Gemma 3 4B (Q4_0) | dense | 4,6 Go | 3 s | 80,8 → 63,6 | 6 239 → 5 409 | très fluide |
| Qwen2.5-Coder 7B (Q8_0) | dense | 10,2 Go | 3 s | 30,0 → 23,3 | 3 746 → 2 138 | fluide |
| gpt-oss 20B (MXFP4) | MoE, 3,6 Md actifs | 13,0 Go | 4 s | 81,4 → 62,5 | 4 950 → 3 316 | très fluide |
| Qwen3.8 27B (Q4_K_XL) | dense | 19,1 Go | 5 s | 11,8 → 10,6 | 865 → 717 | correct |
| Qwen3.6 35B-A3B (Q4_K_XL) | MoE, 3 Md actifs | 22,4 Go | 5 s | 66,0 → 55,6 | 2 987 → 2 429 | très fluide |
| GLM-4.7-Flash (Q8_0) | MoE, 3 Md actifs | 32,6 Go | 6 s | 51,4 → 35,5 | 2 392 → 608 | très fluide |
| Qwen3-Coder 30B-A3B (Q8_0) | MoE, 3,3 Md actifs | 34,3 Go | 6 s | 62,6 → 33,2 | 3 377 → 1 603 | très fluide |
| Llama 3.3 70B (Q4_K_M) | dense | 51,1 Go | 8 s | 4,8 → 3,9 | 405 → 269 | idéal en traitement par lots |
| gpt-oss 120B (MXFP4) | MoE, 5,1 Md actifs | 61,7 Go | 10 s | 58,0 → 42,2 | 2 609 → 1 832 | très fluide |
| Qwen3.5 122B-A10B (Q4_K_XL) | MoE, 10 Md actifs | 74,5 Go | 12 s | 23,1 → 21,4 | 1 126 → 945 | fluide |
| Nemotron-3 Super 120B-A12B (Q4_K_XL) | MoE, 12 Md actifs | 80,4 Go | 12 s | 16,9 → 16,5 | 851 → 809 | correct |
| Qwen3.8-Flash-Next 125B (IQ4_XS) | MoE, environ 6 Md actifs | 89,5 Go | 21 s | 27,3 → 25,2 | 1 073 → 917 | fluide |
| Qwen3-235B-A22B (Q2_K_XL) | MoE, 22 Md actifs | 90,5 Go | 12 s | 17,7 → 11,8 | 588 → 331 | correct ; compression forte (Q2) |
Pour lire le tableau : un modèle dense fait travailler tous ses paramètres à chaque token, un modèle MoE (« mixture of experts ») seulement une fraction, indiquée en milliards (Md). Le sigle entre parenthèses désigne la compression des poids. Dans nos fichiers, Q8 occupe 8,5 bits par paramètre, les formats Q4 et MXFP4 de 4,3 à 5,6 bits, et Q2_K_XL 3 bits : c'est la compression la plus forte du tableau.
La colonne « Usage » applique nos repères à la vitesse d'écriture à contexte vide : très fluide au-delà de 40 tokens par seconde, fluide de 20 à 40, correct de 10 à 20. En dessous, nous réservons le modèle aux traitements par lots.
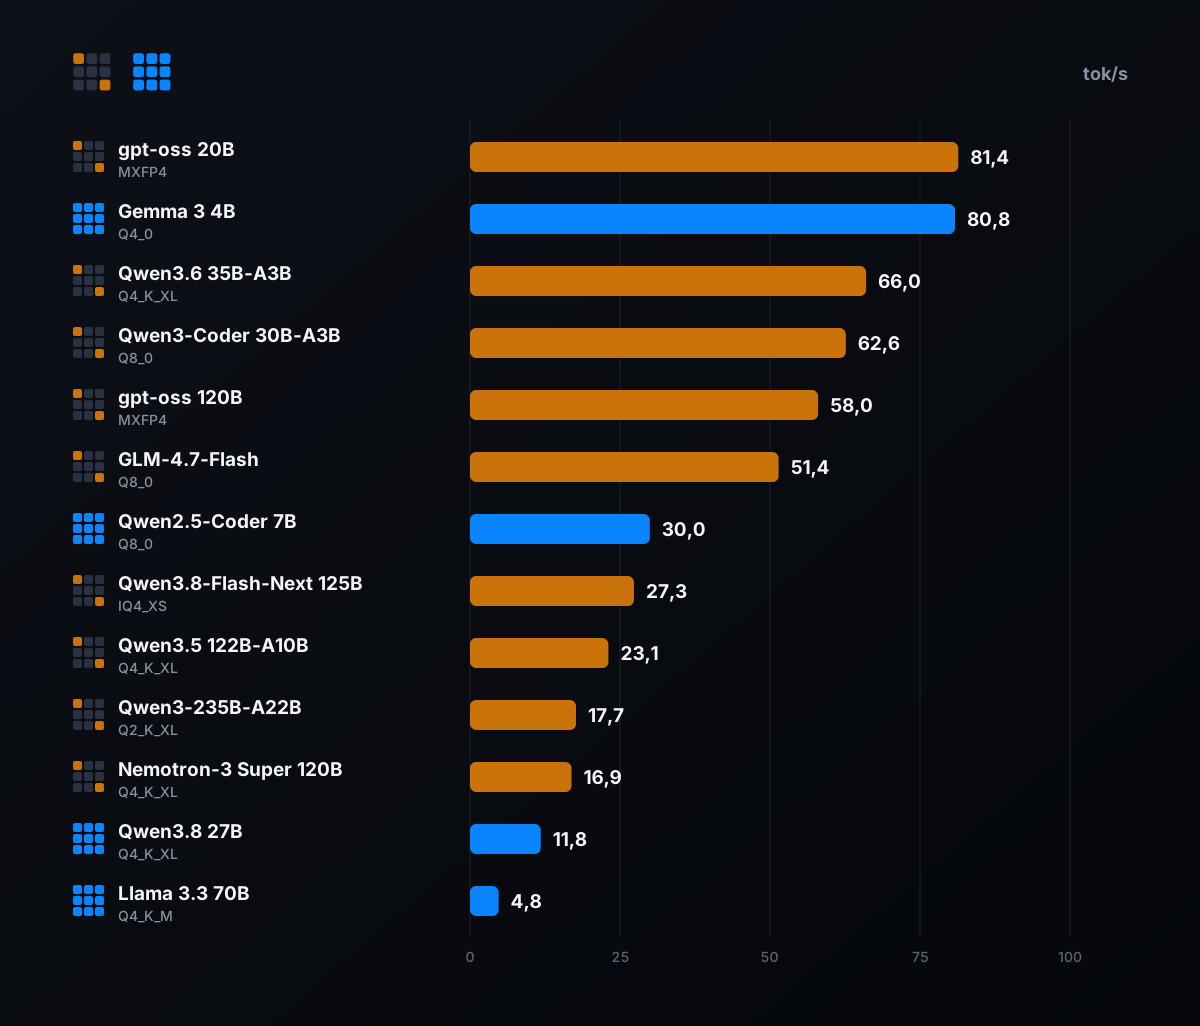
Premier enseignement : rien dans ce tableau ne met la machine en difficulté ; même Qwen3-235B laisse 21 Go libres avec 30 000 tokens de contexte. Second enseignement, plus utile pour choisir : la place n'est presque jamais une limite ; c'est le choix du modèle qui fixe la vitesse, de 4,8 à 81,4 tokens par seconde.
#Ce qui fixe la vitesse : les paramètres actifs, pas la taille
Pour écrire chaque token, la puce doit relire en mémoire les poids qui servent à ce token. Avec 273 Go/s de bande passante, la vitesse maximale se calcule simplement : 273 divisé par le volume de poids lus à chaque token. Un modèle dense lit tous ses poids à chaque fois ; un modèle MoE n'en lit qu'une fraction, les « experts » choisis pour ce token.
C'est ce qui explique le paradoxe du tableau. Le fichier de gpt-oss 120B pèse 59 Go, mais le modèle n'active que 5,1 milliards de paramètres par token : il écrit à 58,0 tokens par seconde. Qwen3.8 27B, dont le fichier est plus de trois fois plus léger (16 Go), est un modèle dense : il active ses 27 milliards de paramètres à chaque token et écrit à 11,8 tokens par seconde. Le gros modèle va près de cinq fois plus vite que le petit.
| Modèle | Paramètres actifs | Plafond théorique | Mesuré | Part du plafond |
|---|---|---|---|---|
| Qwen2.5-Coder 7B (dense) | 7,6 Md | 33,7 | 30,0 | 89 % |
| Llama 3.3 70B (dense) | 70,6 Md | 6,4 | 4,8 | 74 % |
| Qwen3.8 27B (dense) | 27,3 Md | 15,6 | 11,8 | 76 % |
| Qwen3-Coder 30B-A3B (MoE) | 3,3 Md | 77,8 | 62,6 | 81 % |
| gpt-oss 120B (MoE) | 5,1 Md | 98,7 | 58,0 | 59 % |
| Qwen3.6 35B-A3B (MoE) | 3 Md | 141,1 | 66,0 | 47 % |
Le tableau retient six modèles, ceux dont le nombre de paramètres actifs est publié ou relevé par llama.cpp. Les modèles denses atteignent 74 à 89 % de ce plafond : la GB10 tire presque tout de sa mémoire.
Sur l'ensemble des treize modèles, les huit MoE hors Qwen3.8-Flash-Next en atteignent 47 à 81 %, six d'entre eux entre 52 et 62 % ; le choix des experts et les calculs annexes ajoutent probablement un temps fixe à chaque token. Qwen3.8-Flash-Next n'entre pas dans ce calcul : il compte 51 milliards de paramètres de table de consultation en plus de ses 125 milliards, ce qui rend l'estimation inadaptée.
À taille comparable, les MoE restent pourtant bien plus rapides. D'où notre conseil principal : sur une machine GB10, pour un grand modèle, privilégiez un MoE. Un petit modèle dense comme Gemma 3 4B écrit aussi très vite (80,8 tokens par seconde), mais il est bien plus petit et sert d'autres usages.
#Les modèles de plus de 100 milliards de paramètres
C'est la raison d'être des 128 Go. NVIDIA annonce pour la plateforme des modèles jusqu'à 200 milliards de paramètres ; nos mesures confirment cette promesse, et un 235B compressé à 3 bits tient même au-delà. Cinq modèles de plus de 100 milliards de paramètres tiennent sur l'ATOM, tous avec au moins 20 Go de marge à 30 000 tokens de contexte.
- gpt-oss 120B, le meilleur compromis vitesse et place
- 58,0 tokens par seconde, 61,7 Go occupés avec son contexte, chargé en 10 secondes. OpenAI le publie directement au format MXFP4 : il tient sans compression supplémentaire.
- Qwen3.8-Flash-Next 125B, le plus rapide des Qwen géants
- 27,3 tokens par seconde avec environ 6 milliards de paramètres actifs, 89,5 Go occupés en IQ4_XS. Sa version Q4_K_XL, moins compressée, tient aussi, avec une marge étroite (voir plus bas).
- Qwen3.5 122B-A10B
- 23,1 tokens par seconde, 74,5 Go ; ses dix milliards de paramètres actifs le placent derrière gpt-oss.
- Nemotron-3 Super 120B-A12B (NVIDIA)
- 16,9 tokens par seconde, 80,4 Go. Avec douze milliards de paramètres actifs, il écrit moins vite que gpt-oss, et c'est le modèle dont l'écriture tient le mieux quand le contexte s'allonge : 16,5 à 32 768 tokens, environ 3 % de moins.
- Qwen3-235B-A22B, à part
- Il tient en Q2_K_XL, la compression la plus forte du tableau (3 bits par paramètre en moyenne) : 17,7 tokens par seconde, 90,5 Go. Une compression aussi forte réduit en général la qualité des réponses ; nous ne l'avons pas mesurée.
#Où s'arrête la mémoire : autour de 100 à 105 Go de poids
Le système voit 121,7 Go de mémoire : une partie des 128 est réservée dès le démarrage. Une fois la machine lancée, sans rien d'autre en mémoire, 108 à 113 Go restaient disponibles selon les moments. Pour trouver le plafond, nous avons chargé deux versions plus lourdes des plus gros modèles, avec le même contexte de 32 768 tokens et un garde-fou qui coupe le chargement si la mémoire libre tombe sous 3 Go.
| Modèle | Fichier | Mémoire occupée | Marge restante | Écriture (après 4 000 → 30 000 tokens lus) | Place |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B (Q4_K_XL) | 103,7 Go | 107,0 Go | 6,0 Go | 24,9 → 21,9 tok/s | juste |
| Qwen3-235B-A22B (Q3_K_XL, 3,5 bits) | 97,0 Go | 104,7 Go | 8,2 Go | 13,9 → 10,4 tok/s | juste |
Aucun modèle n'a échoué au chargement, mais ces deux-là laissent une marge étroite : guère de place pour un second modèle, un contexte bien plus long ou une application gourmande à côté. La limite pratique se situe donc autour de 100 à 105 Go de poids. Elle exclut par exemple les poids NVFP4 (un format compressé de NVIDIA) de Qwen3.8-Flash-Next : environ 135 Go selon le blog Kubesimplify (27 août 2026), qui précise qu'il faut alors deux machines.
Ce même billet montrait déjà le modèle sur une seule machine en GGUF (le format de llama.cpp), mais seule la version la plus compressée existait alors. Sur l'ATOM, les versions IQ4_XS et Q4_K_XL tournent, avec 21 et 6 Go de marge.
#Le prix du contexte long
Un long document, une base de code ou une conversation qui s'étire : chaque token déjà présent dans le contexte ralentit la suite. Avec 32 768 tokens en mémoire, la vitesse d'écriture baisse de 3 à 47 % selon les modèles. Nous avons aussi mesuré le temps réel pour lire d'un bloc un document de 30 000 tokens, une cinquantaine de pages.
| Modèle | Lecture de 30 000 tokens | Écriture ensuite |
|---|---|---|
| Gemma 3 4B | 4,7 s | 60,8 tok/s |
| gpt-oss 20B | 8,1 s | 61,6 tok/s |
| Qwen2.5-Coder 7B | 12,7 s | 23,3 tok/s |
| Qwen3.6 35B-A3B | 14,2 s | 54,4 tok/s |
| Qwen3-Coder 30B-A3B | 17,4 s | 33,3 tok/s |
| gpt-oss 120B | 21,8 s | 42,8 tok/s |
| GLM-4.7-Flash | 32,7 s | 35,6 tok/s |
| Qwen3.8 27B | 39,4 s | 10,6 tok/s |
| Qwen3.8-Flash-Next 125B | 42,9 s | 23,0 tok/s |
| Qwen3.5 122B-A10B | 43,6 s | 21,2 tok/s |
| Nemotron-3 Super 120B-A12B | 55,4 s | 16,2 tok/s |
| Qwen3-235B-A22B | 1 min 33 s | 12,1 tok/s |
| Llama 3.3 70B | 1 min 44 s | 4,0 tok/s |
Pour la plupart des modèles, ces temps sont plus longs que ne le suggère la colonne « Lecture » du premier tableau. La raison probable : llama-server, le serveur utilisé en pratique, traite par défaut le texte par lots de 512 tokens, contre 2 048 dans notre configuration de llama-bench.
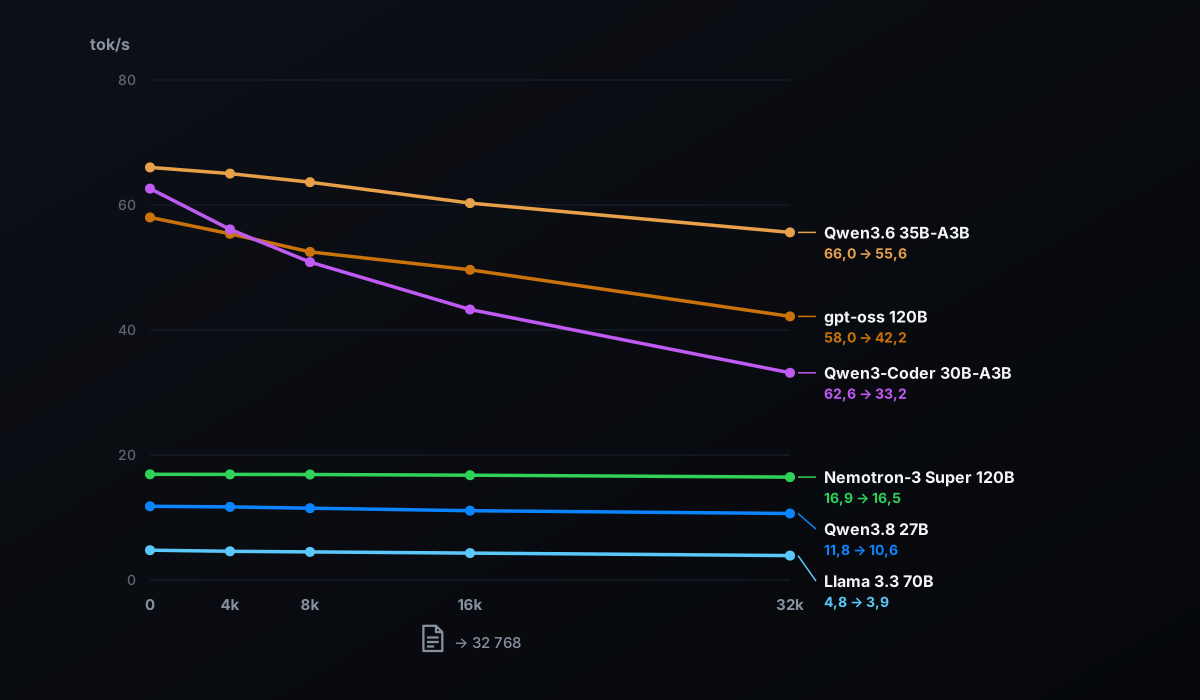
La lecture est un point fort de la GB10 : face au Mac comparé plus bas, elle lit gpt-oss 120B 31 % plus vite. Si vous déposez un rapport d'une cinquantaine de pages, la réponse commence 22 secondes plus tard avec gpt-oss 120B, et 1 min 44 s plus tard avec un 70B dense. Pour l'analyse de documents et les agents de code, ce critère pèse lourd.
#Jusqu'à 16 utilisateurs en même temps : ce que la machine tient
Avec vLLM, nous avons simulé 1, 8 puis 16 utilisateurs simultanés. Chacun envoie une demande de 1 024 tokens et reçoit une réponse de 512 tokens ; chaque point est mesuré trois fois avec des requêtes différentes, et nous publions la médiane.
| Modèle | Utilisateurs | Total | Par personne | Premier mot (moyenne) | Premier mot (cas les plus lents) |
|---|---|---|---|---|---|
| gpt-oss 120B | 1 | 35,6 tok/s | 36,4 tok/s | 0,34 s | 0,35 s |
| gpt-oss 120B | 8 | 113,9 tok/s | 14,5 tok/s | 0,97 s | 1,62 s |
| gpt-oss 120B | 16 | 160,3 tok/s | 10,2 tok/s | 1,07 s | 3,71 s |
| gpt-oss 20B | 1 | 49,1 tok/s | 50,0 tok/s | 0,16 s | 0,16 s |
| gpt-oss 20B | 8 | 205,9 tok/s | 26,5 tok/s | 0,49 s | 0,81 s |
| gpt-oss 20B | 16 | 322,4 tok/s | 20,7 tok/s | 0,52 s | 1,73 s |
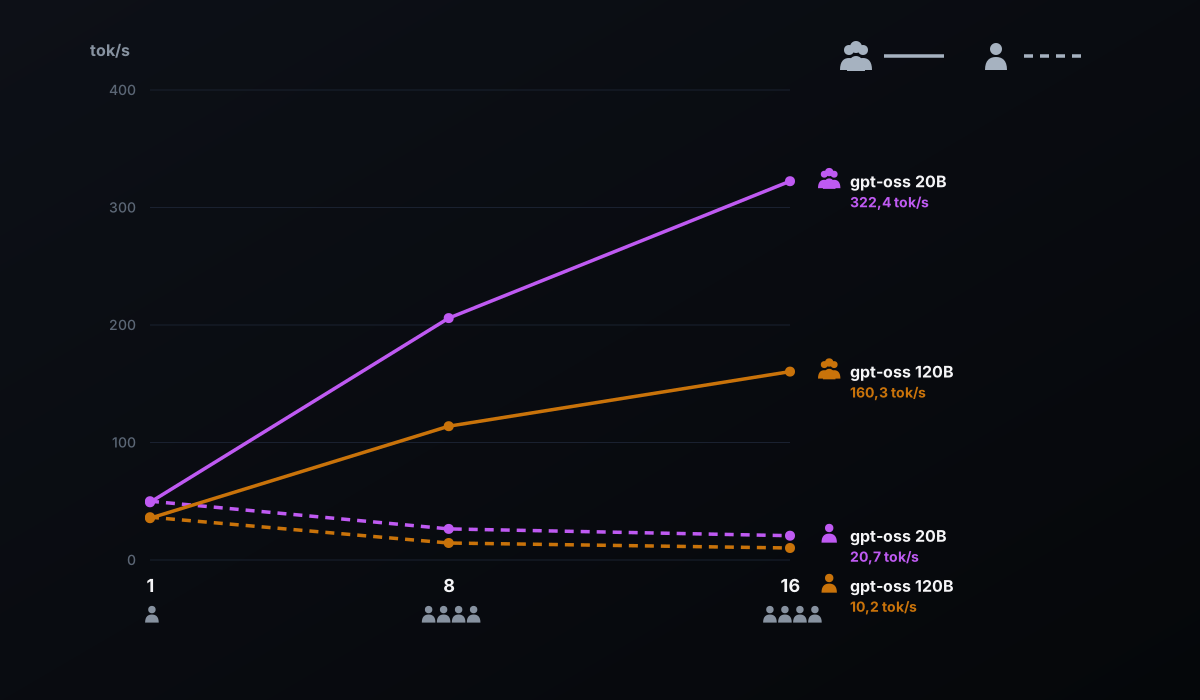
Entre 1 et 16 utilisateurs, le débit total est multiplié par 4,5 avec gpt-oss 120B et par 6,6 avec gpt-oss 20B : quand plusieurs requêtes partagent la lecture des mêmes poids, la puce exploite pleinement sa puissance de calcul.
À 16 personnes, chacune voit encore sa réponse s'écrire à 10 tokens par seconde avec gpt-oss 120B, et à 21 avec gpt-oss 20B. Avec le modèle de 120 milliards, le premier mot arrive en un peu plus d'une seconde en moyenne, et en près de 4 secondes dans les cas les plus lents.
Pour une personne seule, en revanche, vLLM n'est pas le plus rapide : sans réglage de performance particulier, il écrit à 36,4 tokens par seconde sur gpt-oss 120B, contre 54,4 pour llama.cpp sur des réponses longues. Ses journaux montrent qu'il choisit sur la GB10 le noyau de calcul Marlin pour le format MXFP4, ce qui explique probablement l'écart. vLLM se justifie dès que plusieurs personnes ou plusieurs agents partagent la machine.
#Seul devant la machine : Ollama ou llama.cpp ?
Ollama est la façon la plus simple de démarrer, et il fonctionne sur la GB10 sans réglage. Sur gpt-oss, il n'est pourtant pas le plus rapide. Sur des réponses longues, la version 0.34.1 écrit à 42,3 tokens par seconde sur gpt-oss 120B, contre 54,4 pour llama.cpp au même format MXFP4, soit 22 % de moins. Sur gpt-oss 20B : 58,8 contre 78,8, soit 25 % de moins.
Sur les modèles Qwen, c'est l'inverse. Sur Qwen3.8 27B, Ollama écrit entre 22,9 et 30,5 tokens par seconde selon le passage, contre 11,8 pour llama.cpp réglé par défaut ; sur Qwen3.6 35B-A3B, entre 90,5 et 94,9, contre 66,0. La raison probable : Ollama y active par défaut un décodage spéculatif, qui propose plusieurs tokens d'avance que le modèle valide d'un coup (le réglage draft_num_predict apparaît dans la configuration de ces modèles).
Notre test va dans ce sens. Sur llama-server (six textes de 400 tokens, prose et code), le décodage spéculatif de llama.cpp (MTP, qui prédit plusieurs tokens à la fois) fait passer Qwen3.8 27B de 11,7 à 21,5 tokens par seconde en prose, et de 11,6 à 27,2 en code.
En pratique : Ollama pour démarrer et pour les modèles Qwen, qu'il accélère d'office ; llama.cpp pour tirer le maximum de gpt-oss, ou de Qwen3.8 en activant son décodage spéculatif. Le meilleur choix dépend des réglages plus que de la machine.
#Face au MacBook Pro M5 Max 128 Go
Un lecteur a mesuré son MacBook Pro M5 Max 128 Go (GPU de 40 cœurs) le 16 septembre avec Ollama 0.34.1, en un seul passage par modèle ; ses relevés sont publiés dans notre guide dédié. Nous avons rejoué les mêmes séries sur l'ATOM, en deux passages : même version d'Ollama, mêmes modèles, même prompt.
| Mesure | ATOM, 1er passage | ATOM, 2e passage | MacBook Pro M5 Max | Écart |
|---|---|---|---|---|
| Écriture, gemma4:12b | 45,9 | 54,1 | 58,1 | Mac +7 à +27 % |
| Écriture, qwen3.8:27b | 30,5 | 22,9 | 36,6 | Mac +20 à +59 % |
| Écriture, gpt-oss:20b | 58,1 | 58,8 | 113,4 | Mac +93 à +95 % |
| Écriture, gpt-oss:120b | 42,2 | 42,3 | 79,1 | Mac +87 % |
| Lecture, gpt-oss:120b | 1 816 | — | 1 388 | ATOM +31 % |
Le Mac écrit plus vite sur les quatre modèles, près de deux fois plus vite sur les deux gpt-oss, dont les passages concordent : sa puce dispose de 614 Go/s de bande passante, plus du double de la GB10. Sur gemma4 et qwen3.8, l'écart varie d'un passage à l'autre ; le décodage spéculatif, dont le gain dépend du texte généré, en est une explication possible.
L'ATOM lit plus vite, probablement grâce à la puissance de calcul de son GPU, sur des textes proches mais non identiques (16 850 et 16 689 tokens). Avec llama.cpp, l'écart d'écriture se réduit : 54,4 tokens par seconde sur gpt-oss 120B, contre 79,1 pour le Mac sous Ollama.
#Pour qui l'ATOM est le bon choix
Ce qui suit vient de nos mesures sur l'ATOM.
- L'ATOM est le bon choix si vous voulez de grands modèles chez vous
- Cinq modèles de plus de 100 milliards de paramètres tiennent avec de la marge. À notre connaissance, aucune carte graphique grand public n'approche ces 128 Go.
- … si vous travaillez sur de longs documents ou du code
- 30 000 tokens lus en 22 secondes avec gpt-oss 120B.
- … si plusieurs personnes ou agents la partagent
- 160 tokens par seconde au total pour 16 utilisateurs sur gpt-oss 120B.
- … si vous voulez l'écosystème NVIDIA
- CUDA 13, vLLM dans le conteneur de NVIDIA et llama.cpp compilé pour la puce GB10 ont fonctionné chez nous sous DGX OS 7.5.0.
- Si vous êtes seul et visez d'abord la vitesse d'écriture
- Comparez avec le MacBook Pro M5 Max : grâce à ses 614 Go/s, il écrit plus vite sur gpt-oss, quand l'ATOM lit un long document 31 % plus vite sur gpt-oss 120B. Comparez aussi les prix.
- Si vos modèles restent sous 35 Go
- La version 64 Go de l'ATOM, annoncée pour le 23 octobre 2026, devrait suffire (calcul tiré de nos mesures, non mesuré sur cette version).
#64 ou 128 Go ?
Le 2 octobre 2026, NVIDIA a annoncé des DGX Spark de 64 Go pour des modèles jusqu'à 100 milliards de paramètres, disponibles le 23 octobre chez Acer, ASUS, Dell, GIGABYTE, HP et MSI, dès 4 999 dollars. GIGABYTE a confirmé le 5 octobre une AI TOP ATOM 64 Go au même design. Nous ne l'avons pas mesurée.
Nos relevés permettent un calcul. Les modèles jusqu'à Qwen3-Coder 30B-A3B occupent moins de 35 Go avec 32 768 tokens de contexte et tiendraient ; Llama 3.3 70B (51 Go) serait à la limite. gpt-oss 120B (62 Go) et les modèles plus gros ne tiendraient pas. À bande passante égale, ce qu'il faudra vérifier, les vitesses devraient être proches.
Pour un modèle de plus de 100 milliards de paramètres sur une seule machine, la version 128 Go s'impose. Selon NVIDIA, deux machines de 64 Go reliées mettent aussi leur mémoire en commun ; nous ne l'avons pas testé.
#Les prix relevés
Le 8 octobre 2026, la version 4 To en PCIe 4.0 (ATAGB10-9001, même puce GB10 et mêmes 128 Go) s'affichait à 6 346,27 € TTC sur la boutique officielle AORUS, épuisée ; elle était en stock sur Amazon.fr, vendue par Amazon UK (un exemplaire). La version testée, 4 To en PCIe 5.0 (ATAGB10-9000), était à 7 999,95 € chez LDLC et chez Materiel.net, en rupture.
Prix et stocks de ces machines changent vite : vérifiez-les avant d'acheter.
#Notre verdict
L'ATOM est un excellent choix pour faire tourner chez soi un modèle de 120 milliards de paramètres, le partager avec une équipe ou lire vite de longs documents. Elle nous a donné les performances de référence de la plateforme, sans limitation thermique signalée dans nos relevés, y compris pendant une heure de charge continue à 16 utilisateurs. Si le budget compte, sa version PCIe 4.0 garde la même puce et la même mémoire.
#Ce que nous n'avons pas mesuré
- La qualité des réponses
- Ce guide mesure ce qui tient et à quelle vitesse, pas ce que vaut chaque modèle.
- Les températures, le bruit et la consommation
- Le guide suivant de la série détaille les températures en charge longue ; la consommation a son propre guide, lue sur la puce (GPU seul). Pour le bruit, nous citons les mesures de Hardware & Co.
- Les contextes au-delà de 32 768 tokens
- Plusieurs modèles acceptent des contextes bien plus longs ; ce guide s'arrête à 32 768 tokens, et le tutoriel 70B de la série va jusqu'à 131 072 tokens pour Llama 3.3 70B et gpt-oss 120B.
- Les autres machines GB10 et la version 64 Go
- Nos chiffres rejoignent ceux publiés pour le DGX Spark de NVIDIA, mais nous n'avons mesuré que l'ATOM 128 Go.
Mises à jour et corrections : cette page sera révisée si une nouvelle version de DGX OS, de llama.cpp ou d'Ollama change ces résultats ; chaque correction sera datée.
#FAQ
Quel est le plus gros modèle qu'on peut faire tourner sur une machine GB10 de 128 Go ?+
Un modèle 70B est-il utilisable au quotidien sur une GB10 ?+
Les vitesses de ce guide valent-elles pour un DGX Spark de NVIDIA ou une autre marque ?+
Faut-il choisir la version 64 Go ou 128 Go ?+
Ollama est-il le meilleur choix sur une machine GB10 ?+
Un retour, une erreur, une précision ? Faites-nous signe, ça améliore le guide pour tout le monde.