Le guide de référence · 25 chapitres · configs incluses · mises à jour à vie
Ton copilote de code,
100 % local
Le kit Copilote Local : LE guide de référence pour monter ton propre copilote IA sur ta machine — de la première commande à l'agent qui code dans ton éditeur. Ton code et tes données ne quittent jamais ton disque.
Obtenir le kit — 24 €24 € · paiement unique · mises à jour à vie incluses
Qu'est-ce que le kit Copilote Local ?
Le kit Copilote Local est un guide de référence de 25 chapitres, avec les configs Cline, Aider et Tabby et un espace en ligne à vie mis à jour chaque mois. Il s'adresse aux développeurs, freelances et étudiants qui veulent coder avec une IA locale dans VS Code, sur un GPU à partir de 8 Go de VRAM ou un Mac Apple Silicon, en 30 minutes, pour remplacer l'essentiel d'un usage GitHub Copilot ou Cursor.
- 25 chapitres et 8 modules avancés, environ 175 pages au format PDF.
- Configs prêtes à coller pour Cline, Aider et Tabby, plus les Modelfiles Ollama.
- Bibliothèque de 44 prompts organisés par modèle et par rôle.
- Compatible dès 8 Go de VRAM (GPU dédié) ou Mac Apple Silicon.
- Premier copilote fonctionnel en VS Code en environ 30 minutes.
- 24 € en paiement unique, mises à jour à vie incluses, satisfait ou remboursé 30 jours.
✓ Pour toi si…
tu veux ton propre copilote IA sur ta machine — développeur pro, freelance, étudiant, ou simplement à l'aise avec un ordinateur. La confidentialité, le coût ou la dépendance au cloud te dérangent, et tu as un GPU avec quelques Go de VRAM ou un Mac Apple Silicon.
✗ Pas pour toi si…
tu veux un assistant qui code des projets entiers tout seul en multi-repos, ou si la moindre milliseconde de latence te coûte de l'argent. Sur ces terrains, le cloud garde l'avantage — et on te le dit dans le guide.
Pourquoi tu peux t'y fier
Ce guide est écrit et maintenu par l'équipe de QuelLLM.fr — 249 modèles indexés, 262 guides en français, mis à jour chaque matin — qui opère aussi des plateformes IA en production toute l'année (RegulIA, IAPRO). Chaque config du kit est testée sur nos propres machines — des GPU de bureau comme une RTX 5070 Ti sous Linux, pas un cluster cloud. Ce que tu lis ici, c'est notre terrain : condensé, testé, sans détour. Pas une compilation de tutos trouvés au hasard. Qui est derrière QuelLLM →
Le problème
Depuis le 24 avril 2026, GitHub Copilot s'entraîne sur ton code par défaut (Free/Pro/Pro+). Cursor coûte de plus en plus cher et facture à l'usage. Et à chaque prompt, ton code propriétaire transite chez un tiers.
Tu sais qu'un LLM local règle tout ça. Mais entre « quel modèle pour ma carte ? », la quantization, Ollama qui plante et 12 onglets de tutos contradictoires… tu n'as toujours pas un setup qui marche vraiment. Le kit est LA méthode de référence : le chemin complet, testé de bout en bout, configs comprises — sans rien avoir à chercher ailleurs.
Le copilote local vs GitHub Copilot vs Cursor
Le même travail dans VS Code — sans abonnement et sans envoyer ton code ailleurs. Le comparatif honnête :
| Copilote local | GitHub Copilot | Cursor | |
|---|---|---|---|
| Ton code reste sur ta machine | Oui | Non | Non |
| Entraîné sur ton code | Jamais | Oui, par défaut | Selon réglages |
| Coût | 0 €/mois | ~10 €/mois | ~20 €/mois |
| Fonctionne hors-ligne | Oui | Non | Non |
| Chat + agent sur ton repo | Oui (Cline) | Oui | Oui |
| Autocomplétion | Oui (avec GPU) | Oui | Oui |
| Raisonnement multi-repos lourd | Limité | Fort | Fort |
Le guide te montre comment couvrir ~90 % de ton usage Copilot/Cursor en local — et te dit franchement où le cloud garde l'avantage.
Ce que tu obtiens
- Ton espace en ligne, à vie — les 25 chapitres lisibles en web, toujours la dernière édition, chaque commande copiable en un clic (les tokens FIM exotiques survivent au copier-coller, ce qu'un PDF ne garantit pas).
- Le guide complet en PDF (~175 pages) — le même contenu, à toi pour toujours, hors-ligne.
- Les configs prêtes à coller — Cline (VS Code), Aider (terminal), Tabby (autocomplétion), par palier de VRAM.
- Les Modelfiles optimisés + une bibliothèque de 44 prompts — par modèle et par rôle (chat / édition / autocomplétion), tokens FIM corrects inclus.
- 8 modules avancés — benchmarker ta machine, multi-projets, RAG sur ta doc, pre-commit local, durcissement, prompts — et les nouveaux : ton ChatGPT privé (Open WebUI / AnythingLLM) et l'IA locale au travail (RGPD, AI Act, note DSI).
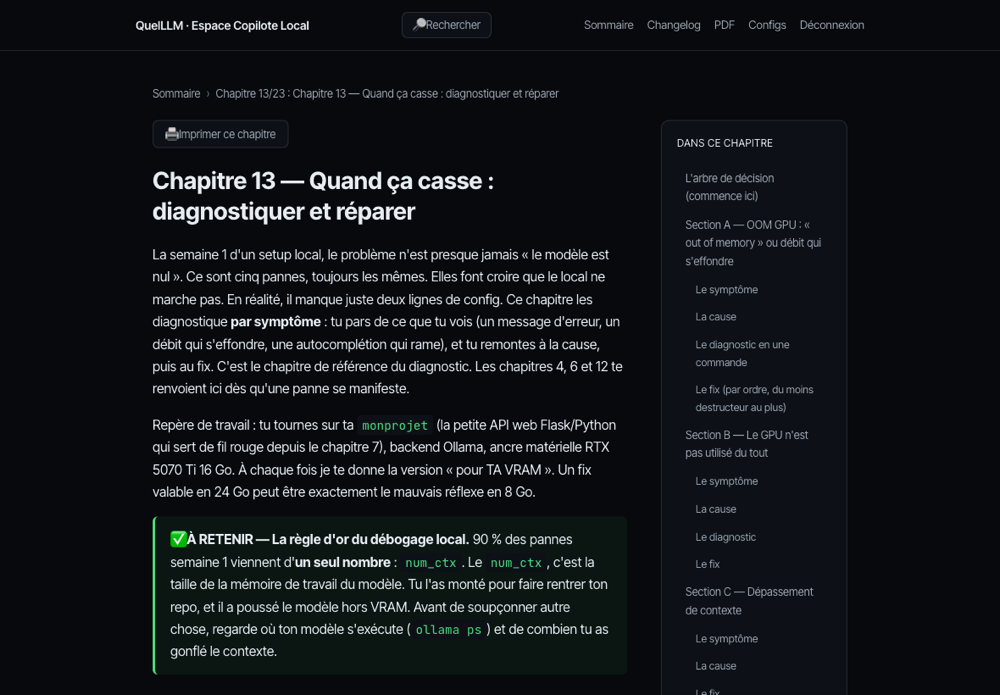
- Le chapitre « quand ça casse » — OOM, GPU non utilisé, lenteur : le diagnostic + le fix pour chaque panne.
- Le cheat-sheet — ta VRAM → le bon modèle → la commande, sur une page.
- Édition vivante — tu reçois chaque mise à jour mensuelle (nouveaux modèles, configs re-réglées) sans rien repayer.
Stack : Ollama + Cline + Aider + Tabby. Modèles : Qwen2.5-Coder, Qwen3-Coder, Devstral, DeepSeek-Coder. 100 % local, 0 €/mois.
Les 25 chapitres du kit
~175 pages, du quick-win en 30 minutes aux modules avancés que tu ne trouveras nulle part ailleurs en français. Rien à sauter : chaque chapitre renvoie vers les suivants.
- Pourquoi coder en local en 2026
- Ton premier copilote local en 30 minutes
- Ce que le local te donne, et où il perd
- Installer Ollama proprement
- Le bon modèle selon ta VRAM
- Ta machine suffit-elle, et quand upgrader
- Cline + Ollama dans VS Code
- Aider dans le terminal, ton pair-programmeur git-aware
- Autocomplétion FIM : le Copilot inline, en local
@codebase: du RAG sur ton repo- Modelfiles par modèle × rôle
- Les réglages qui changent tout
- Quand ça casse : diagnostiquer et réparer
- Le vrai modèle de coût
- Modèle de menace concret : ce qui sort de ton poste
- Lire une édition datée dans le temps
- Update Log daté + Annexe A : aller plus loin
- Benchmarker TA machine en 10 minutes (VRAM réelle + tok/s réel, pas la fiche technique)
- Workflow multi-projets : plusieurs repos, un seul Ollama
- RAG local sur de la doc (pas ton code — tes PDF, tes specs)
- Hook pre-commit 100 % local : un relecteur avant chaque push
- Durcir le setup : du « rien ne sort » prouvé à la garantie permanente
- Bibliothèque de 44 prompts disciplinés, prêts à copier-coller
- Ton ChatGPT privé : un assistant local pour tout, pas que le code (Open WebUI / AnythingLLM)
- L'IA locale au travail : convaincre ton entreprise (RGPD, AI Act, note DSI prête à envoyer)
Chaque édition mensuelle enrichit ce sommaire (Update Log daté, ch.16-17) — tu ne rachètes rien à la prochaine version.
Installé en 30 minutes, pas à pas
Pas besoin d'être expert. Le guide te tient la main, de la première commande au copilote qui répond dans ton éditeur :
1 · Installe Ollama
Une commande. Le guide te dit quel modèle tirer selon ta carte (la table VRAM plus bas).
2 · Tire le bon modèle
ollama run qwen2.5-coder:7b — et tu vérifies que ton GPU bosse vraiment.
3 · Branche ton éditeur
Cline (chat + agent dans VS Code), Aider (terminal), Tabby (autocomplétion). Configs fournies, à coller.
4 · Code
Refactor, explique, génère, débugge — sur ton repo, hors-ligne, sans qu'une ligne parte dans le cloud.
- L'espace en ligne à vie : 25 chapitres toujours à jour (sommaire complet plus haut), commandes copiables en 1 clic
- Le guide PDF (~175 pages) + le pack de configs, Modelfiles & 44 prompts à télécharger
- Le cheat-sheet + le chapitre dépannage
- Toutes les éditions mensuelles, à vie — elles apparaissent dans ton espace
- Accès immédiat après paiement, clé d'accès envoyée par email
Paiement sécurisé par Stripe. Tu repars avec le PDF + les configs en moins d'une minute. Facture PDF envoyée automatiquement · TVA non applicable, art. 293 B du CGI.
La vérité honnête
Le local remplace ~90 % de ton usage Copilot/Cursor — pas 100 %. On te dit franchement où il gagne, et où le cloud garde l'avantage. Un guide de référence te doit cette carte honnête :
À la fin, tu sais faire
- Choisir le bon modèle pour TA machine (et savoir lequel éviter) en 10 secondes.
- Avoir un chat + agent dans VS Code (Cline) qui lit ton repo, refactore, explique — en local.
- Une autocomplétion qui marche (bons tokens FIM, bon modèle), pas une qui invente.
- Diagnostiquer et réparer seul quand ça plante (OOM, GPU, lenteur).
- Coder hors-ligne, sans abonnement, sans qu'une ligne de ton code parte ailleurs.
Édition vivante — le changelog public
« Mises à jour à vie » n'est pas un slogan : le kit suit l'écosystème (rachats, dépréciations, nouveaux modèles) pour toi. La preuve, datée :
v2026.09 (édition actuelle) — le kit s'ouvre au-delà du code (23 → 25 chapitres) : ton ChatGPT privé (Open WebUI / AnythingLLM, RAG sur tes documents, prompts non-dev) + l'IA locale au travail (argumentaire RGPD / AI Act + note DSI prête à envoyer, template inclus dans le pack).
v2026.08 — 6 modules avancés ajoutés (17 → 23 chapitres) : benchmarker ta machine, workflow multi-projets, RAG sur ta doc, hook pre-commit local, durcissement, bibliothèque de 44 prompts.
v2026.07 — stack re-ancrée sur Cline + Aider + Tabby/Twinny après le rachat de Continue.dev par Cursor (18/06/2026) · Modelfiles Qwen2.5-Coder / Qwen3-Coder / Devstral / DeepSeek-Coder re-réglés · tokens FIM vérifiés octet par octet.
Beaucoup de tutos gratuits recommandent encore Continue. Toi, tu pars sur la stack qui a un futur — et chaque édition mensuelle t'arrive sans repayer.
Questions fréquentes
Comment remplacer GitHub Copilot par une IA locale ?
Tu installes Ollama, tu tires un modèle de code (ex. Qwen2.5-Coder), puis tu branches Cline dans VS Code (ou Aider au terminal) sur Ollama. Le kit donne le chemin exact + les configs prêtes à coller — comptez 30 minutes.
Quelle IA locale choisir pour coder ?
Selon ta VRAM : Qwen2.5-Coder 7B (8 Go), 14B (12 Go), Devstral 24B (16 Go), 32B (24 Go). Le cheat-sheet du kit te donne le bon modèle et la commande exacte pour ta machine.
Peut-on vraiment utiliser Ollama dans VS Code ?
Oui : l'extension Cline (chat + agent) pour le raisonnement et le refactor, et Tabby ou Twinny pour l'autocomplétion. Les configs exactes — et les bons tokens FIM — sont fournies dans le pack.
Ça marche hors ligne ?
Oui. Une fois le modèle téléchargé, tout fonctionne sans connexion : chat, refactor, génération, autocomplétion — 100 % local.
Faut-il être développeur pour suivre le kit ?
Non. Le kit part de zéro : installer Ollama, choisir le modèle adapté à ta machine, brancher ton éditeur — chaque étape est guidée, commandes à copier-coller. Si tu sais installer un logiciel et ouvrir un terminal, tu peux le suivre. Les modules avancés t'attendent pour la suite.
Et si ma machine ne suffit pas ?
Le chapitre « ta machine suffit-elle ? » te le dit en 5 minutes (paliers dès 8 Go de VRAM, Apple Silicon compris). Si elle ne suffit pas, tu le sais avant d'acheter, pas après. Pas sûr ? vérifie en 30 secondes avec le configurateur (gratuit) →
Est-ce adapté en entreprise et pour le RGPD ?
C'est justement l'intérêt : ton code ne quitte jamais ta machine, rien n'est envoyé à un tiers ni utilisé pour entraîner un modèle. Le kit trie aussi les licences utilisables au travail (Apache 2.0 / MIT) de celles à éviter.
Est-ce gratuit ?
Le LLM tourne en local : 0 €/mois, pas d'abonnement, pas de limite d'usage. Le kit (guide + configs + espace en ligne à vie) est un achat unique à 24 €.
Et si ça ne marche pas sur ma machine, après achat ?
Satisfait ou remboursé pendant 30 jours — un email suffit, sans justification.
C'est livré comment ?
Accès immédiat après paiement : ton espace en ligne à vie (lecture toujours à jour, lien personnel envoyé par email) + le PDF et le zip des configs à télécharger. Accès et téléchargements permanents — et si tu perds l'email, tu redemandes ton lien en 10 secondes.
Puis-je avoir une facture (pro / note de frais) ?
Oui, automatiquement. Dès le paiement (Stripe), tu reçois par email ton reçu Stripe et ta facture PDF au nom de Falcon Consulting (éditeur de QuelLLM), à tes coordonnées — indique ton entreprise ou ton SIREN dans le champ prévu au moment du paiement. TVA non applicable, art. 293 B du CGI : le prix affiché est le prix final.
Et si QuelLLM.fr ferme un jour ?
Le PDF (~175 pages) et le zip de configs sont à toi, téléchargés sur ta machine — ils ne dépendent pas du site. L'espace en ligne est un confort de lecture, pas une condition d'accès.
Quelle différence avec les guides du site ?
Les guides du site expliquent chaque brique séparément. Le kit est LA méthode de référence : les 25 chapitres dans le bon ordre, les configs testées et maintenues (Cline, Aider, Tabby, Modelfiles), le dépannage complet et 8 modules avancés qui n'existent nulle part ailleurs en français — le tout mis à jour chaque mois. C'est le système complet pour monter ton copilote local, pas une collection d'articles.
Quelle alternative gratuite à GitHub Copilot ?
L'alternative gratuite la plus complète est un copilote 100 % local : Ollama plus l'extension Cline dans VS Code, sur un modèle comme Qwen2.5-Coder. Le LLM tourne sur ta machine, donc gratuit et hors ligne, sans abonnement mensuel. Le kit Copilote Local détaille l'installation et les configs prêtes à coller pour chaque palier de VRAM.
Comment coder avec une IA en local ?
Coder avec une IA en local demande trois briques : Ollama pour faire tourner le modèle, un modèle de code adapté à ta VRAM (Qwen2.5-Coder par exemple), et une extension dans ton éditeur comme Cline ou Aider pour l'agent et l'autocomplétion. Le kit Copilote Local regroupe ce parcours avec les commandes et configs testées.
Cline ou Continue avec Ollama ?
Cline. Continue.dev appartient à Cursor depuis juin 2026 : le projet continue, mais son avenir pour un usage 100 % local avec Ollama n'est plus garanti. Cline reste open-source, indépendant et activement maintenu, avec le chat, l'agent et le refactor sur ton repo. Le kit Copilote Local documente les configs Cline (et Aider) à jour.
Monte ton copilote local.
Le guide de référence, du premier téléchargement au copilote qui répond dans ton éditeur — privé, sans abonnement, sur ta machine. Aujourd'hui, pas « un jour ».
Obtenir le kit — 24 €