AI TOP ATOM vs DGX Spark : quelles différences réelles ?
Une GIGABYTE AI TOP ATOM et un DGX Spark de NVIDIA reposent sur la même puce GB10 et sur les mêmes 128 Go de mémoire. Nos mesures sont à 4,3 % près au plus de celles publiées pour le DGX Spark avec llama.cpp, et à 2 % près avec Ollama. GIGABYTE apporte son propre châssis, du même format d'un litre que la Founders Edition, son refroidissement et ses six références. Pendant 2 heures de charge continue, la vitesse est restée stable, sans aucun ralentissement imposé.
Le DGX Spark de NVIDIA et l'AI TOP ATOM de GIGABYTE reposent sur la même puce GB10. Qu'est-ce qui change vraiment ? Sur notre AI TOP ATOM, fournie gracieusement par GIGABYTE, nous avons rejoué trois séries de mesures publiées pour le DGX Spark, puis mesuré sa tenue en charge pendant 1 et 2 heures, ses températures et son SSD, et vérifié ses ports. Les prix par référence et nos conseils d'achat suivent.
#Même puce NVIDIA GB10, construction GIGABYTE
Le DGX Spark est une plateforme de NVIDIA. Sa puce GB10 réunit 20 cœurs Arm et un GPU de génération Blackwell, qui partagent 128 Go de mémoire annoncée à 273 Go/s. NVIDIA fournit aussi le système DGX OS, le pilote et CUDA. Le DGX Spark vendu par NVIDIA s'appelle la Founders Edition. D'autres constructeurs, dont GIGABYTE, proposent leur propre machine sur la même base.
Cette séparation organise tout le guide. Ce qui vient de NVIDIA se retrouve sur toutes les machines GB10 : la section suivante le vérifie par des mesures. Ce qui vient de GIGABYTE se juge sur le châssis, le refroidissement, le stockage, les références et la garantie. StorageReview, un site américain de tests de matériel, écrit que, comme toutes ces machines partagent la même base GB10, l'écart de performances en IA reste étroit.
| Élément | Fourni par | Sur notre AI TOP ATOM |
|---|---|---|
| Puce GB10 : 20 cœurs Arm, GPU Blackwell | NVIDIA | Vitesses à moins de 5 % de celles publiées (section suivante) |
| Mémoire unifiée de 128 Go, 273 Go/s | NVIDIA (plateforme) | Le système voit 121,7 Go ; une partie est réservée au démarrage |
| DGX OS, pilote, CUDA | NVIDIA | DGX OS 7.5.0, pilote 580.159.03, CUDA 13.0 |
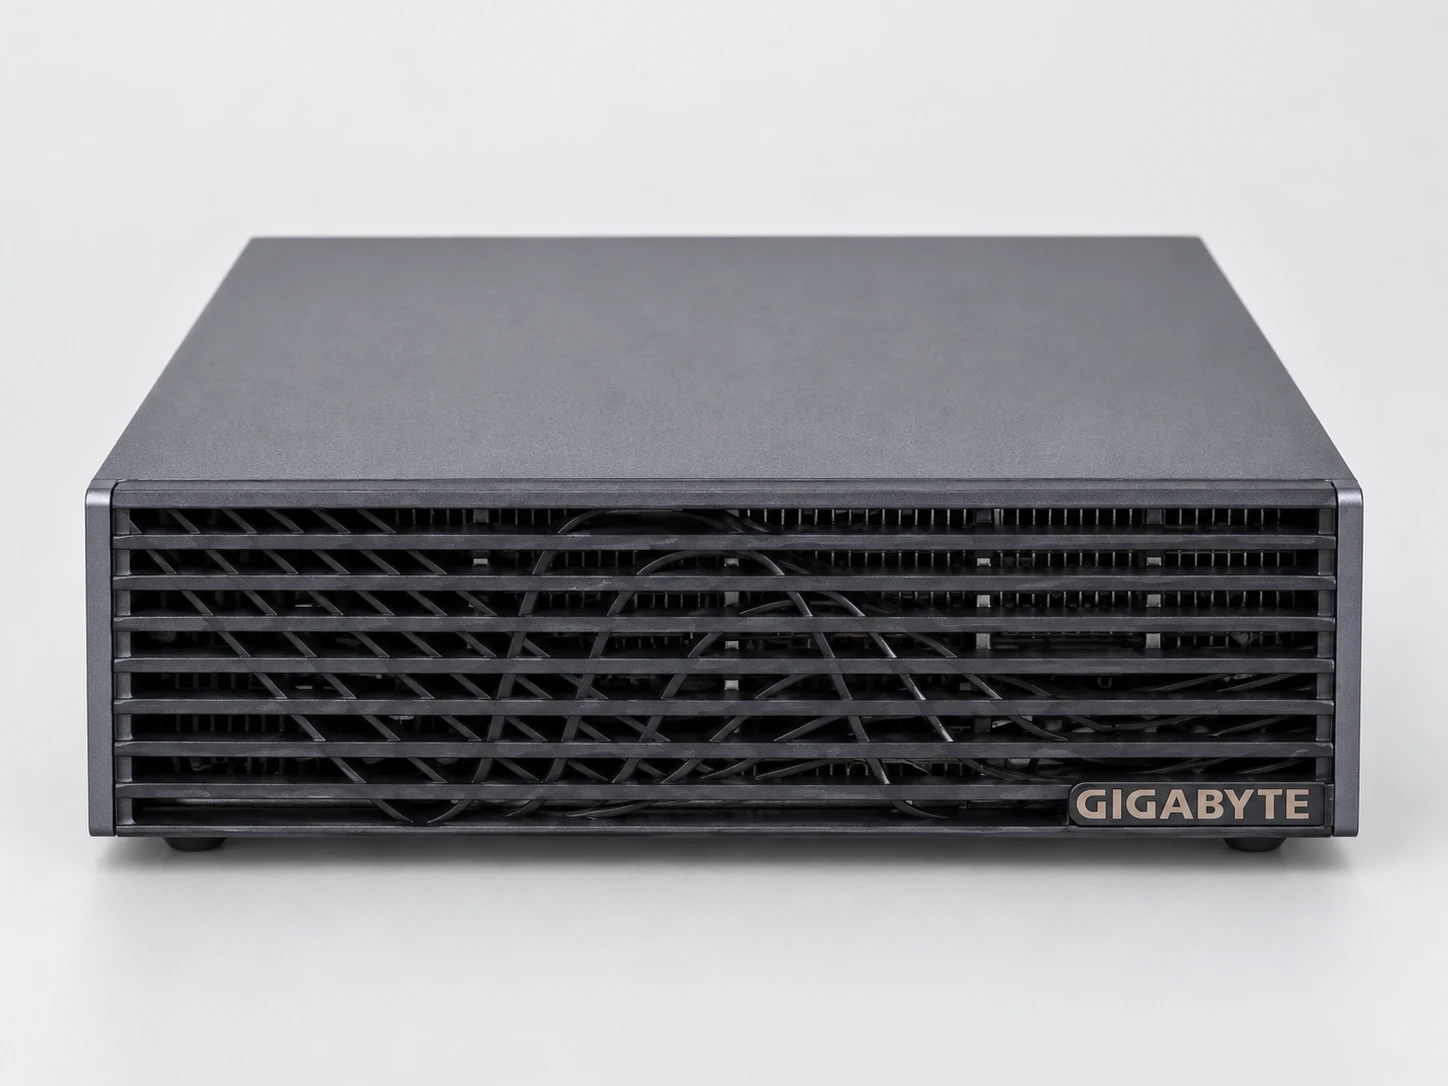
| Format de 150 × 150 × 50,5 mm et 1,2 kg | Même format que la Founders Edition | Boîtier noir mat, façade à lames sans port ni bouton |
| Refroidissement et finition | GIGABYTE | Dissipateur, plaques de cuivre, caloducs et deux ventilateurs, selon ServeTheHome |
| SSD : capacité et génération PCIe | GIGABYTE (selon la référence) | Samsung de 4 To, PCIe 5.0 vérifié (32 GT/s sur 4 lignes) |
| Alimentation de 240 W en USB-C | GIGABYTE (adaptateur fourni) | NVIDIA demande d'utiliser l'alimentation fournie |
| Références, prix, garantie | GIGABYTE et revendeurs | Voir les sections références et prix |
#Les mêmes vitesses que le DGX Spark : trois vérifications
Pour comparer l'ATOM aux références du DGX Spark, nous avons rejoué trois mesures publiées pour cette machine, avec le même outil. Pour llama.cpp et Ollama, la version et les réglages sont aussi les mêmes ; pour vLLM, la version et la commande n'ont pas été publiées. Si notre ATOM donne les mêmes chiffres, elle offre les mêmes performances que la référence.
#Méthode et unités
Chaque vitesse de llama.cpp est la moyenne de 5 répétitions, avec un écart-type sous 3 % (l'écart-type mesure la dispersion des répétitions). La vitesse de lecture est celle avec laquelle la machine absorbe votre texte avant de répondre. La vitesse d'écriture est celle de la réponse qui s'affiche.
Les deux se mesurent en tokens par seconde (tok/s) ; un token est un morceau de mot, environ deux tiers de mot en français. Les mémoires et les débits de disque sont en Go et Go/s, comme l'affiche Linux : 1 Go = 1 024 Mo.
Le protocole a été figé avant la première mesure. Chaque test ajouté ensuite est décrit dans un avenant daté, écrit avant le test. La méthode, la liste datée des avenants et les données de nos tableaux sont publiées sur notre page de méthode.
#Avec llama.cpp : à 4,3 % près
llama.cpp est un moteur open source très répandu pour faire tourner les modèles en local. Le projet publie un tableau de référence pour le DGX Spark, au build 7941 (c'est le numéro de version du logiciel), en février 2026. Nous avons compilé le même build et lancé la même commande sur six modèles et cinq profondeurs de contexte, soit 60 points de mesure. Le contexte est le texte déjà présent en mémoire : de 0 à 32 768 tokens.
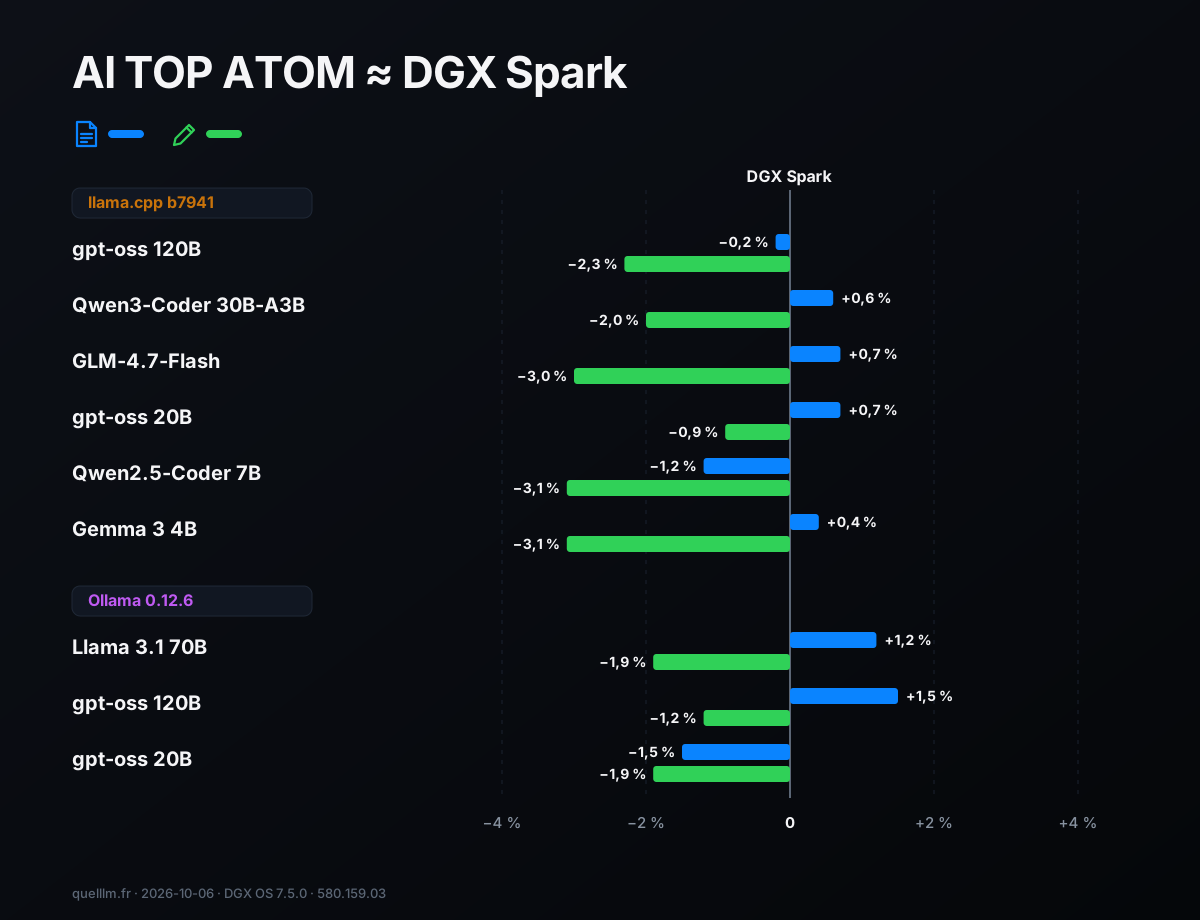
Résultat : la vitesse de lecture est identique à 2,3 % près, avec un écart médian de +0,3 %. La vitesse d'écriture reste au même niveau, avec un écart médian de −2,8 % (4,3 % au plus). Pour gpt-oss 120B, la lecture à contexte vide est égale à la référence : 2 443,9 tok/s des deux côtés. Le tableau de référence date d'un pilote plus ancien (580.95.05) que le nôtre (580.159.03).
#Avec le script officiel d'Ollama : à 2 % près
Ollama a publié ses propres mesures pour le DGX Spark en octobre 2025, avec sa version 0.12.6 et le pilote 580.95.05. Nous avons utilisé la même version et le même script, avec 10 passages et une température de 0. Les trois modèles publiés donnent des résultats à 2 % près, en lecture comme en écriture.
| Modèle | Lecture : nous / publié | Écart | Écriture : nous / publié | Écart |
|---|---|---|---|---|
| gpt-oss 20B | 3 175,0 / 3 224 | −1,5 % | 57,18 / 58,27 | −1,9 % |
| gpt-oss 120B | 1 186,8 / 1 169 | +1,5 % | 40,65 / 41,14 | −1,2 % |
| Llama 3.1 70B | 1 933,6 / 1 911 | +1,2 % | 4,34 / 4,423 | −1,9 % |
#Avec vLLM : même ordre de grandeur, moteur différent
StorageReview a mesuré l'ATOM le 3 mars 2026 avec vLLM, un serveur conçu pour répondre à plusieurs personnes à la fois, sur gpt-oss 120B. StorageReview ne publie ni la version de vLLM ni la commande exacte. Nous avons rejoué ses trois scénarios avec vLLM 26.09, pour 1 et pour 64 utilisateurs.
Nos débits sont du même ordre de grandeur que les siens, au-dessus ou en dessous selon le scénario. Avec un utilisateur, dans le scénario où la machine lit 4 096 tokens et en écrit 512, nous obtenons 304,4 tokens par seconde au total, contre 304,6 pour StorageReview.
Avec 64 utilisateurs, dans le scénario équilibré (256 tokens lus, 256 écrits), nous atteignons 695 tokens par seconde, contre 650. Comme la version de vLLM n'est pas la même, nous présentons ces chiffres comme un même ordre de grandeur et non comme une comparaison de machines. Pendant ces essais, aucune requête n'a été interrompue.
En résumé : avec llama.cpp et Ollama, deux moteurs très utilisés en local, l'ATOM donne, à moins de 5 % près, les mêmes performances qu'un DGX Spark. Pour la vitesse de chaque modèle sur cette puce, voyez notre premier guide de la série.
#Ce que GIGABYTE apporte : châssis, refroidissement, références
L'AI TOP ATOM mesure 150 × 150 × 50,5 mm et pèse 1,2 kg, soit un volume d'environ un litre : c'est le format de la Founders Edition. Le boîtier est noir mat. La façade est à lames, avec un motif ondulé, et ne porte ni port ni bouton : tout se branche à l'arrière.
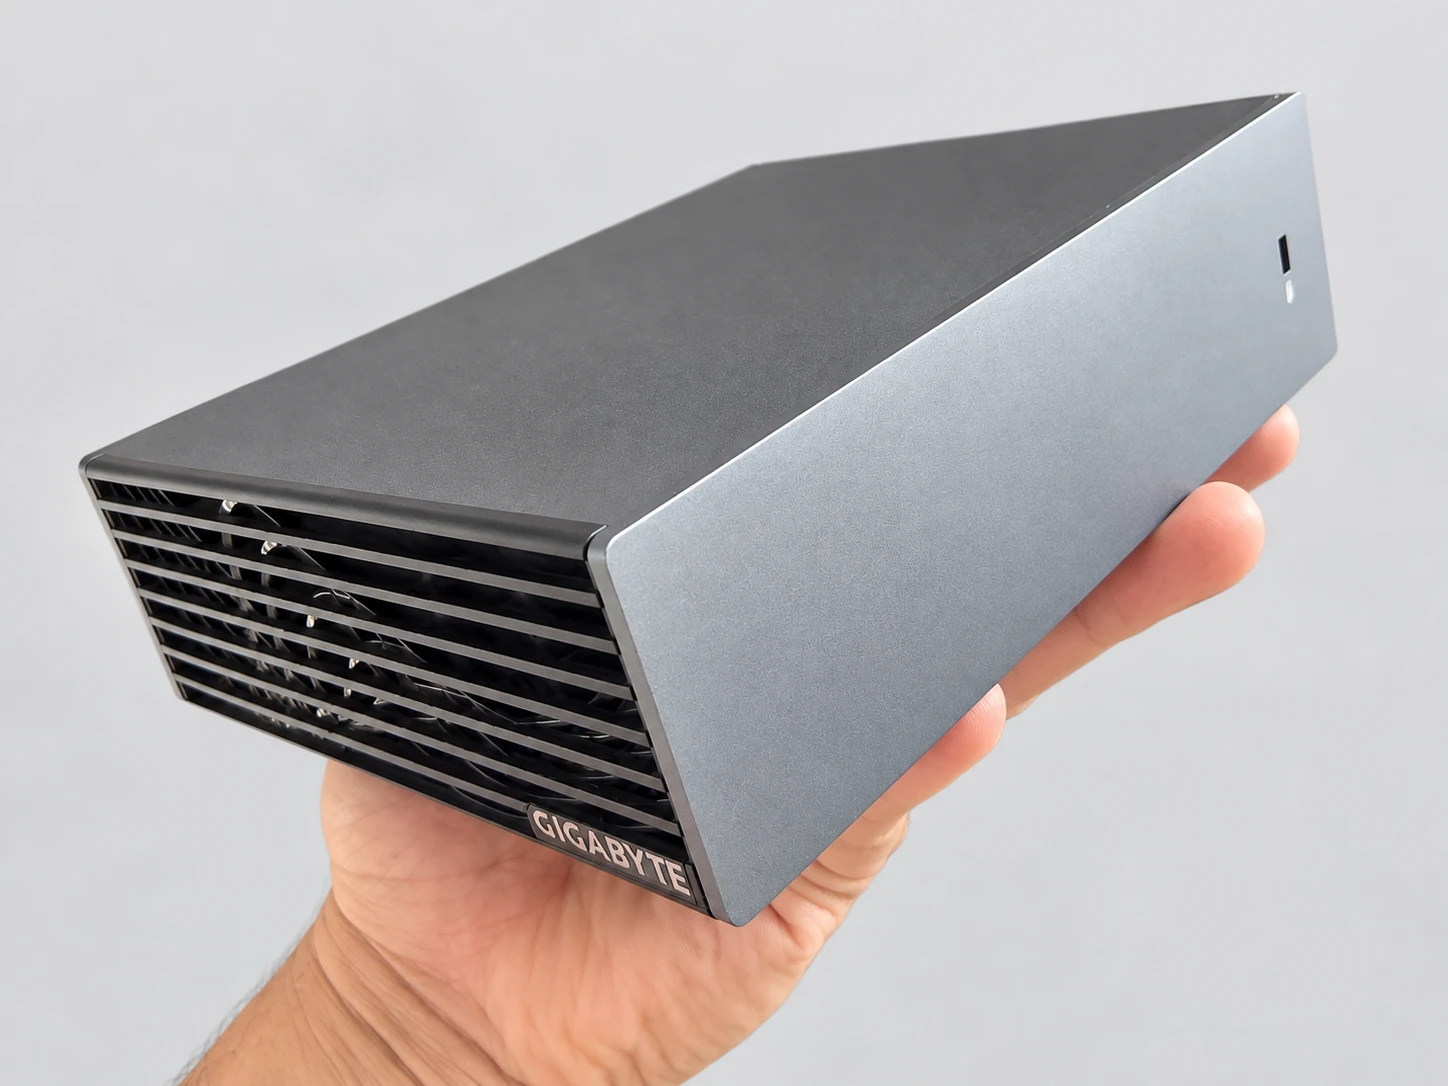
ServeTheHome a ouvert la machine. Il décrit un gros dissipateur, avec des plaques de cuivre sur les puces et des caloducs, refroidi par deux ventilateurs Delta. StorageReview a comparé cinq machines GB10 en janvier 2026. La GIGABYTE atteint 87 à 88 °C au maximum en pointe de charge, comme la Founders Edition et la machine Dell.
StorageReview la classe parmi les meilleurs profils de refroidissement, avec l'un des niveaux de puissance GPU les plus élevés. Après plus d'une heure de chauffe, ServeTheHome trouve l'ATOM au niveau du DGX Spark de NVIDIA, avec un léger avantage dans plusieurs de ses tests d'IA.
Peter Falkingham, qui utilise une ATOM depuis juillet 2026 pour un laboratoire universitaire, la décrit dans son test comme presque silencieuse.
#Six références, avec un SSD au choix
La page produit de GIGABYTE liste six références, de ATAGB10-9000 à ATAGB10-9005. Le tableau donne celles que nous avons pu vérifier.
| Référence | Mémoire | SSD |
|---|---|---|
| ATAGB10-9000 (notre unité) | 128 Go | 4 To en PCIe 5.0 |
| ATAGB10-9001 | 128 Go | 4 To en PCIe 4.0 |
| ATAGB10-9002 | 128 Go | 1 To en PCIe 4.0 |
| ATAGB10-9003 à 9005 | 128 Go ou 64 Go | 2 To ou 1 To en PCIe 4.0 (non vérifié référence par référence) |
Sur la 9000, le SSD est un Samsung de la famille PM9E1, le même modèle que celui de la Founders Edition selon StorageReview. C'est un module M.2 2242. Selon ServeTheHome, c'est le seul composant que l'utilisateur peut remplacer.
#Alimentation, boîte et garantie
L'adaptateur de 240 W se branche sur le port USB-C réservé à l'alimentation. NVIDIA demande d'utiliser l'alimentation fournie pour obtenir les performances optimales. La boîte contient la machine, l'adaptateur et le cordon secteur. Un câble QSFP pour relier deux machines est vendu séparément par GIGABYTE : 94,04 € TTC à la boutique officielle AORUS (relevé du 8 octobre 2026).
Pour la garantie, le manuel de GIGABYTE indique que la durée est précisée sur le site du produit ou sur son étiquette. LDLC annonce 5 ans de garantie sur la 9000 (relevé du 8 octobre 2026). Lisez la durée sur la fiche du revendeur avant d'acheter.
#Ports et connectique
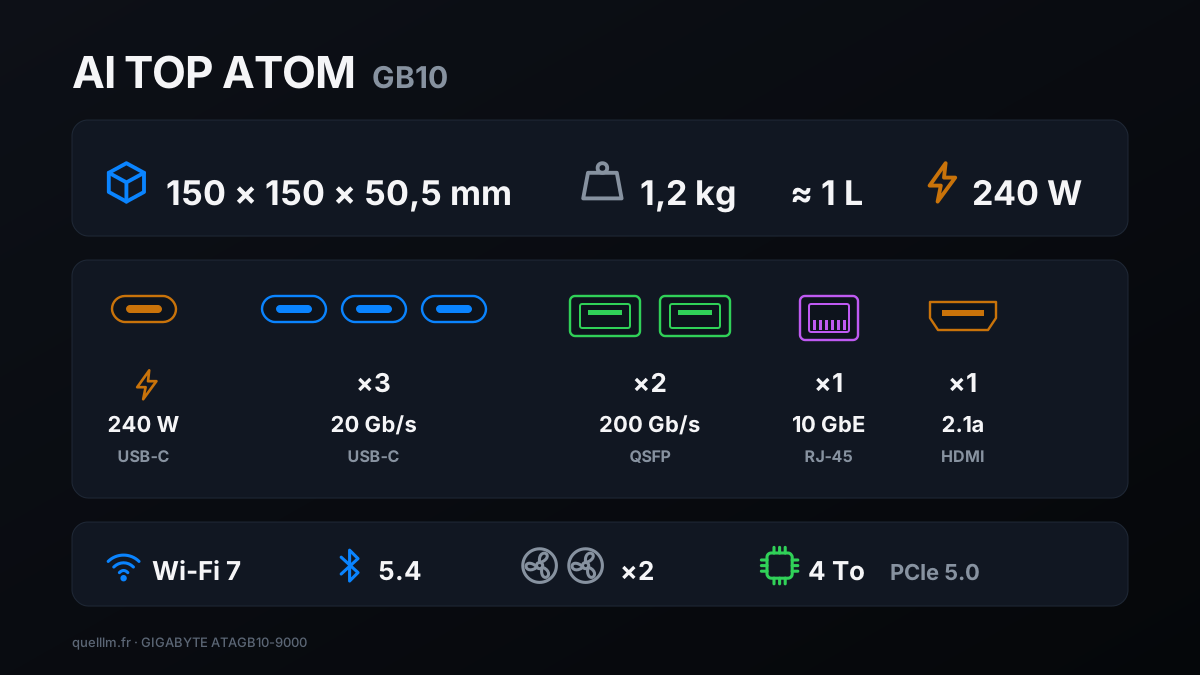
La liste reprend la fiche de GIGABYTE, et la fiche de NVIDIA pour la Founders Edition indique les mêmes ports. Sur notre unité, nous avons vérifié le réseau filaire et le lien du SSD, et identifié le module Wi-Fi.
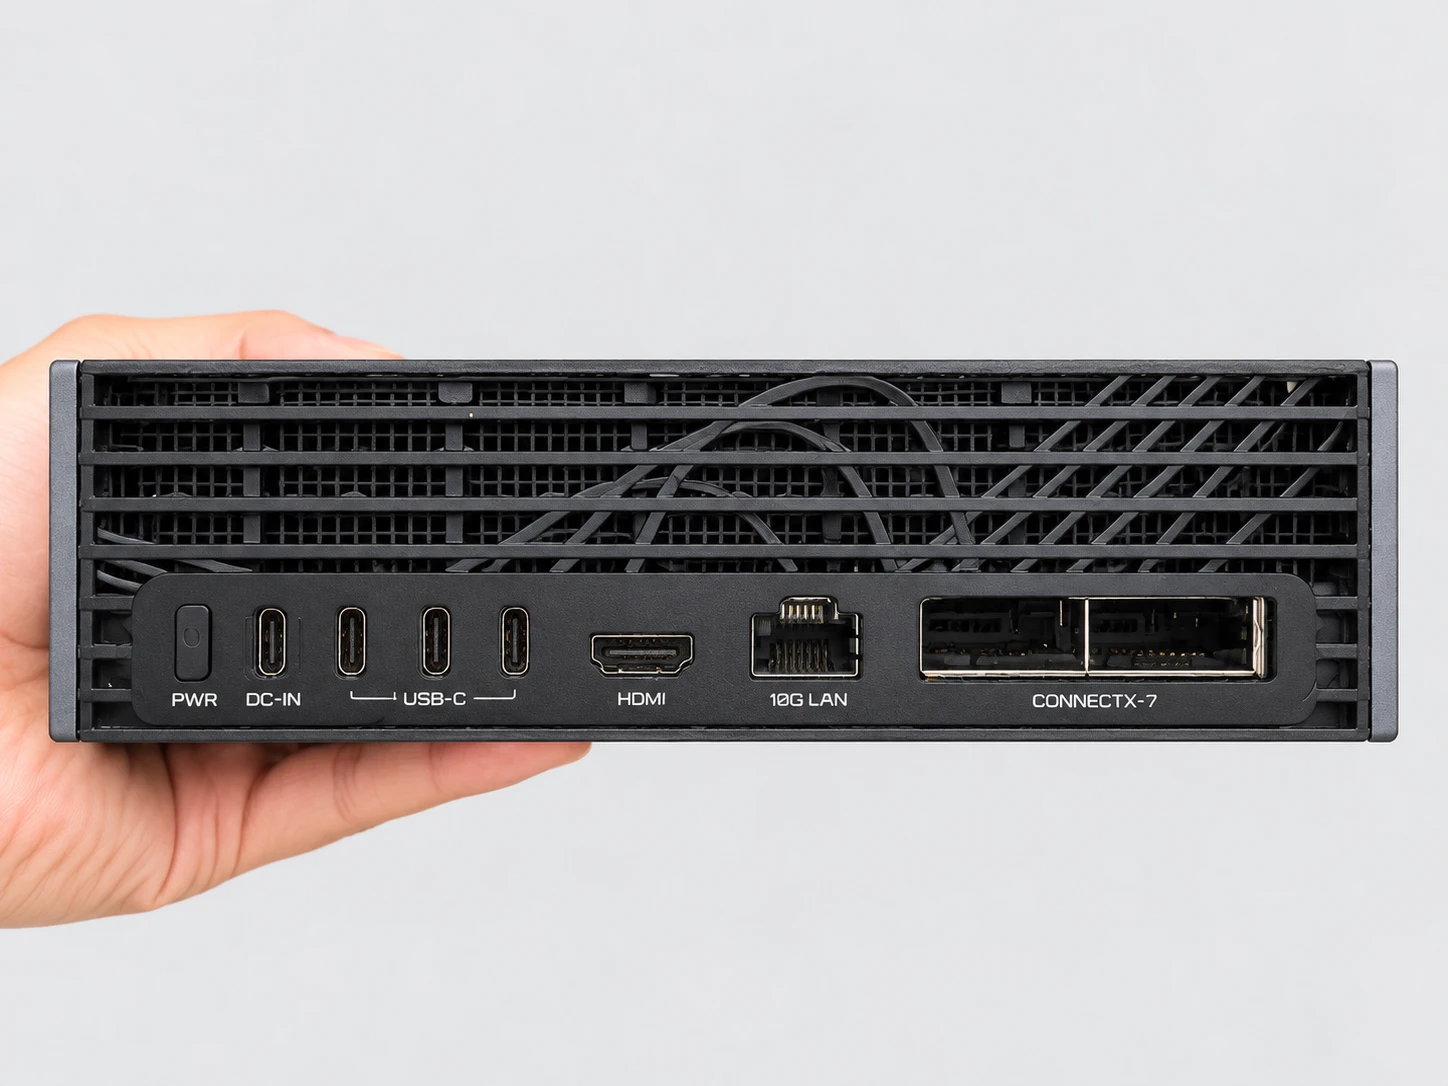
- Alimentation
- Un port USB-C réservé à l'alimentation, avec l'adaptateur de 240 W fourni.
- USB
- Trois ports USB-C à 20 Gb/s (USB 3.2 Gen 2x2) pour les disques et les accessoires.
- Réseau filaire
- Une prise RJ-45 10 GbE. Sur notre unité, le lien négocié est de 10 Gb/s.
- Réseau haut débit
- Deux ports QSFP (carte NVIDIA ConnectX-7, 200 Gb/s) pour relier plusieurs machines. Nous n'avons pas testé cette liaison.
- Vidéo
- Une sortie HDMI 2.1a, avec audio multicanal.
- Sans fil
- Wi-Fi 7 et Bluetooth 5.4. Notre système identifie une puce MediaTek MT7925.
#Tenue en charge : 1 heure et 2 heures de suite
Une machine compacte doit tenir la charge sans ralentir. Un ralentissement imposé par la chaleur ou par la limite de puissance s'appelle un bridage. Nous avons fait travailler l'ATOM sans pause avec vLLM 26.09. Chaque séance est découpée en tranches : une tranche est un lot de requêtes envoyé à la suite du précédent. Pendant ce temps, nous avons relevé chaque seconde l'horloge du GPU, sa puissance, sa température et les raisons de bridage déclarées par le pilote.
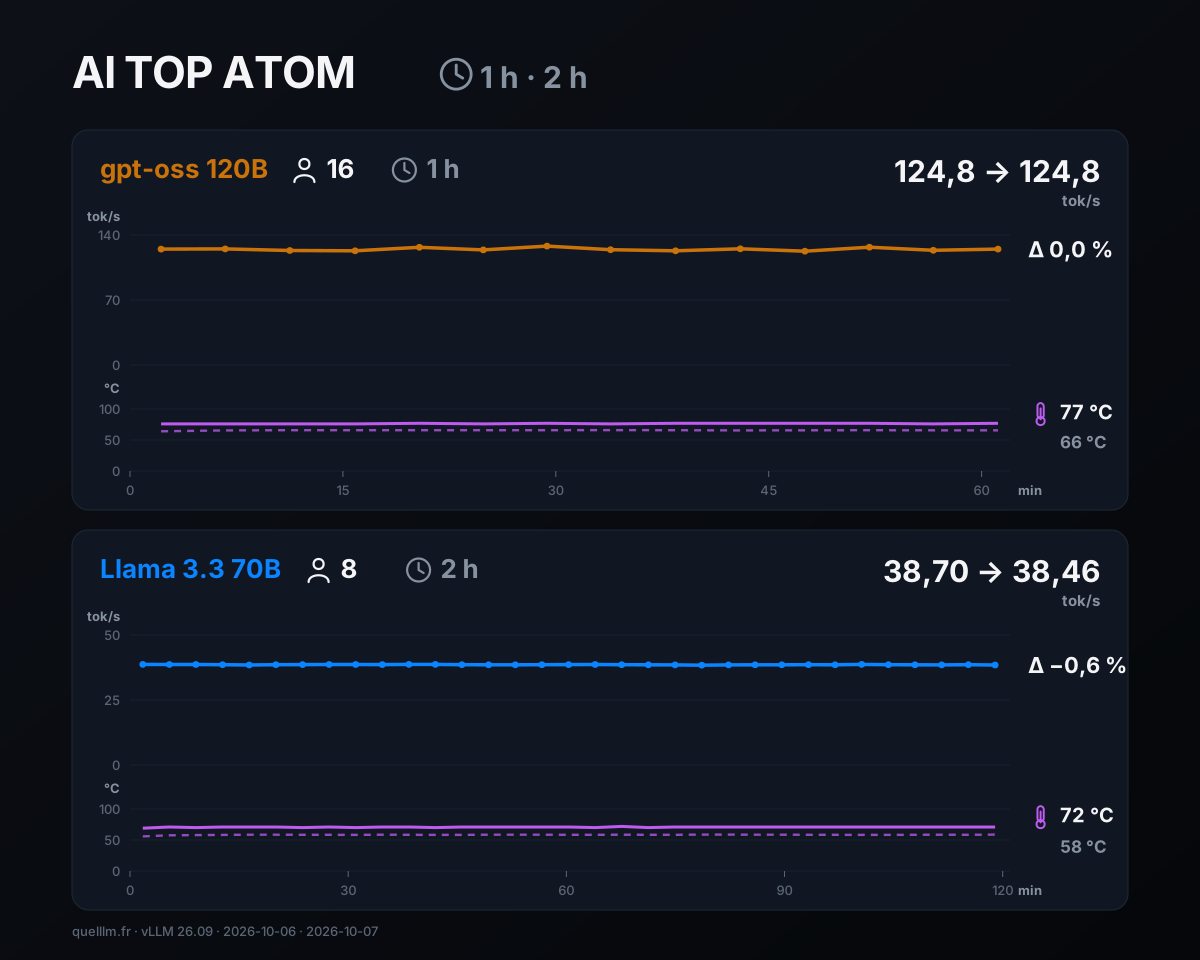
| Séance | Requêtes | Débit : première → dernière tranche | Dérive | Température du GPU | Bridage |
|---|---|---|---|---|---|
| 1 h, gpt-oss 120B, 16 utilisateurs, 14 tranches | 896, aucun échec | 124,8 → 124,8 (de 122,6 à 128,1) | 0,0 % | 77 °C / 66 °C | Aucun |
| 2 h, Llama 3.3 70B NVFP4, 8 utilisateurs, 33 tranches | 1 056, aucun échec | 38,70 → 38,46 (de 38,40 à 38,70) | −0,6 % | 72 °C / 58 °C | Aucun |
Pendant une heure, 16 utilisateurs ont envoyé en continu des demandes de 4 096 tokens, avec des réponses de 512 tokens. Les 14 tranches de 64 demandes ont donné un débit presque identique, de 122,6 à 128,1 tok/s au total, et la première comme la dernière ont atteint 124,8 tok/s. Chaque personne voyait sa réponse s'écrire à environ 8 tok/s. L'horloge du GPU a une médiane de 2 509 MHz sur cette séance.
Pendant deux heures, 8 utilisateurs ont travaillé sur Llama 3.3 70B au format NVFP4, un format compressé de NVIDIA, avec 1 024 tokens lus et 256 écrits par demande. Le débit total est resté entre 38,40 et 38,70 tok/s sur 33 tranches de 32 demandes.
La dérive est de −0,6 % entre la première et la dernière tranche, et de −0,2 % si l'on compare les médianes des cinq premières et des cinq dernières. Chaque personne voyait sa réponse s'écrire à environ 5,1 tok/s, et le premier mot arrivait en 2,8 s (médiane). L'horloge du GPU a une médiane de 2 528 MHz.
Le pilote n'a déclaré aucune raison de bridage pendant les deux séances : la valeur relevée est restée à zéro, seconde après seconde. Le GPU a atteint au plus 77 °C avec 16 utilisateurs et 72 °C avec 8 utilisateurs. La zone la plus chaude des capteurs du système a atteint 87 °C pendant la première séance et 80 °C pendant la seconde.
Pendant la seconde, le SSD a atteint 49 °C au maximum. Le micrologiciel ne nomme pas ces zones : nous ne les attribuons pas au processeur. Pour comparer, StorageReview a relevé au maximum 87 à 88 °C en pointe de charge sur la Founders Edition, la machine Dell et la GIGABYTE.
#Au repos
Après 20 minutes de calme, nous avons relevé la machine pendant 30 minutes. Le GPU consomme en moyenne 10,4 W (de 10,2 à 11,0 W) et reste entre 35 et 36 °C. La zone la plus chaude des capteurs du système monte au plus à 46 °C, et le SSD reste entre 34 et 35 °C. Aucune raison de bridage n'a été déclarée.
La puissance indiquée est celle du GPU, rapportée par ses capteurs ; elle ne représente pas la consommation totale de la machine. La température ambiante n'a pas été consignée. La séance d'une heure a eu lieu en début de soirée et celle de 2 heures de nuit, quand la pièce est probablement plus fraîche.
#Le SSD : 13 Go/s en lecture, 1,28 million d'IOPS
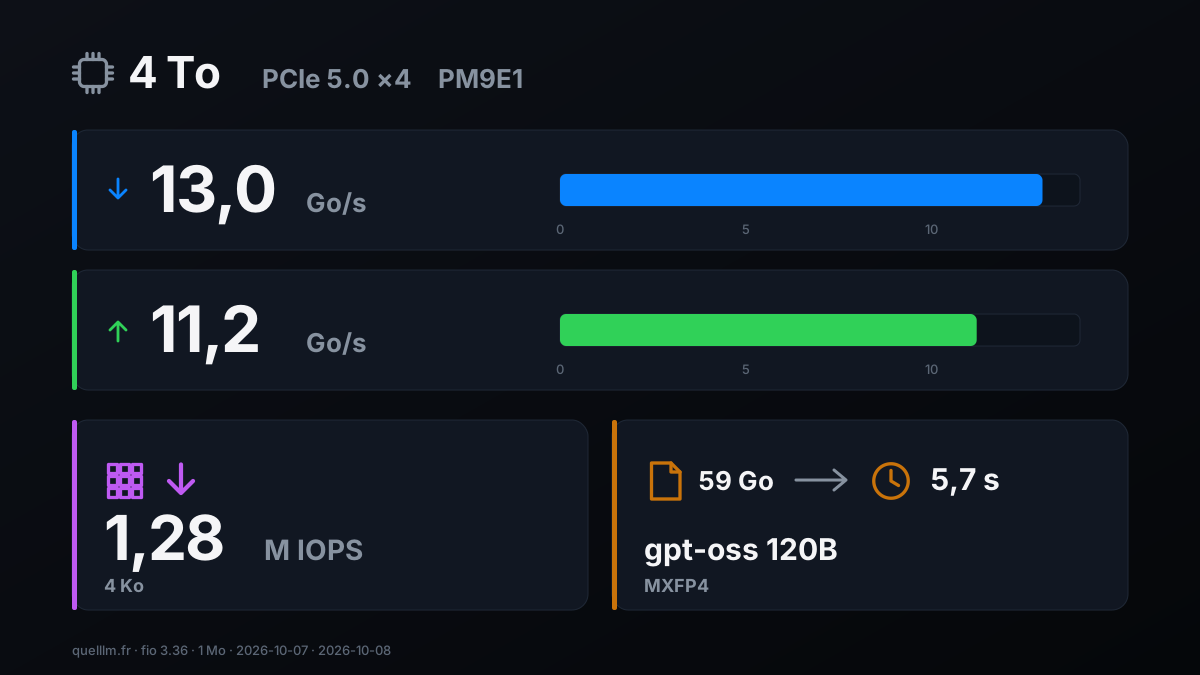
La référence 9000 embarque un SSD Samsung MZALC4T0HBL1 de 4 To, de la famille PM9E1. Le système confirme un lien PCIe 5.0 : 32 GT/s sur 4 lignes. PCIe est la liaison entre le SSD et la puce ; la version 5.0 va deux fois plus vite que la 4.0.
Nous l'avons mesuré avec fio 3.36, sur un fichier de 64 Go entièrement écrit avant la lecture, en accès direct, c'est-à-dire sans passer par le cache du système. Les IOPS sont le nombre d'opérations de lecture ou d'écriture par seconde.
| Test | Résultat |
|---|---|
| Lecture séquentielle, blocs de 1 Mo, 1 tâche | 13,0 Go/s (12,99 avec io_uring, 13,37 avec libaio, deux méthodes d'accès au disque de Linux) |
| Lecture aléatoire, blocs de 4 Ko, 4 tâches | 1,28 million d'IOPS avec io_uring, 1,19 million avec libaio (environ 4,9 Go/s avec io_uring) |
| Écriture séquentielle en rafale, blocs de 1 Mo, fichier neuf de 32 Go, disque au repos | 11,2 Go/s |
| Lecture du fichier de gpt-oss 120B (59 Go) | 5,7 s |
StorageReview a publié, avec un autre outil (gdsio) et le même modèle de SSD, 11,0 à 11,6 Go/s en lecture et 12,2 Go/s en écriture. Nos valeurs sont du même ordre de grandeur, avec une lecture un peu plus haute. En pratique, un grand modèle se charge en quelques secondes : le fichier de gpt-oss 120B, de 59 Go, a été lu en 5,7 s.
Sur la 9000, vous retrouvez le SSD de la Founders Edition de 4 To : c'est le même modèle, il ne distingue donc pas l'ATOM de la référence NVIDIA. La différence existe entre les références de GIGABYTE : la 9000 a un SSD en PCIe 5.0, la 9001 et la 9002 en PCIe 4.0. Les relevés de SSD portent sur la référence 9000.
#64 ou 128 Go ?
Le 2 octobre 2026, NVIDIA a annoncé un DGX Spark de 64 Go pour des modèles jusqu'à 100 milliards de paramètres, disponible le 23 octobre chez Acer, ASUS, Dell, GIGABYTE, HP et MSI, dès 4 999 dollars. GIGABYTE a confirmé le 5 octobre une AI TOP ATOM de 64 Go au même design. La disponibilité en France n'est pas confirmée à ce jour. Nous ne l'avons pas mesurée.
Nos relevés du premier guide de la série permettent un calcul. Les modèles jusqu'à Qwen3-Coder 30B-A3B occupent moins de 35 Go avec 32 768 tokens de contexte et tiendraient dans 64 Go. Llama 3.3 70B (51 Go) serait à la limite. gpt-oss 120B (62 Go) et les modèles plus gros ne tiendraient pas. À bande passante égale, ce qu'il faudra vérifier, les vitesses devraient être proches.
Pour faire tourner un modèle de plus de 100 milliards de paramètres sur une seule machine, la version de 128 Go est nécessaire. Les six références de la page GIGABYTE permettent de choisir sa mémoire et son SSD.
#Prix par référence (relevés du 8 octobre 2026)
Les prix GB10 bougent chaque semaine : vérifiez-les avant d'acheter. Voici ce que nous avons relevé le 8 octobre 2026 en France, TTC. Comparez toujours la même référence : la 9001 (PCIe 4.0) et la 9000 (PCIe 5.0) ne sont pas la même machine.
| Marchand | Référence | Prix TTC | Disponibilité affichée |
|---|---|---|---|
| Boutique officielle AORUS | 9001 (4 To en PCIe 4.0) | 6 346,27 € | Épuisée |
| Amazon.fr, vendu par Amazon UK | 9001 (4 To en PCIe 4.0) | Prix variable, à lire sur Amazon.fr | 1 exemplaire |
| LDLC | 9000 (4 To en PCIe 5.0) | 7 999,95 € | Rupture |
| Rue du Commerce, vendeurs tiers | 9000 (4 To en PCIe 5.0) | À partir de 7 999,95 € (3 offres) | Selon le vendeur |
| Senetic.fr | 9000 (4 To en PCIe 5.0) | 9 022,08 € | 5 unités |
Materiel.net affichait le même prix que LDLC pour la 9000, également en rupture. Pour comparer, le même jour, la MSI EdgeXpert, une autre machine GB10, était affichée à 6 599,95 € chez Materiel.net, en rupture elle aussi ; la DGX Spark de PNY n'y était plus proposée, ni chez LDLC. Un prix affiché pour une machine indisponible n'est pas un prix d'achat : regardez aussi la disponibilité.
#Ce que nous n'avons pas mesuré
- La comparaison avec le DGX Spark
- La comparaison s'appuie sur les mesures publiées pour le DGX Spark, rejouées sur l'ATOM avec les versions de logiciel indiquées.
- Le bruit
- L'appréciation du bruit citée dans cette page provient du test de Peter Falkingham.
- La consommation de la machine entière
- Les puissances de cette page correspondent au GPU seul. Un prochain guide de la série détaille la consommation.
- La température de la pièce
- Les températures publiées proviennent des capteurs intégrés à la machine.
- La liaison entre deux machines
- Les deux ports QSFP (200 Gb/s) n'ont pas été testés.
- Les autres références et la version 64 Go
- Les mesures portent sur la référence ATAGB10-9000 de 128 Go.
Cette page sera mise à jour si une nouvelle version de DGX OS, du micrologiciel ou de nos outils change ces résultats ; chaque correction sera datée.
#Pour qui l'AI TOP ATOM est le bon choix
Ce qui suit vient de nos mesures sur la référence 9000 et de nos relevés de prix du 8 octobre 2026.
- Vous voulez les performances de référence du GB10 dans un boîtier soigné
- La 9000 donne, à 4,3 % près au plus, les vitesses publiées pour le DGX Spark, avec un SSD de 4 To en PCIe 5.0 mesuré à 13 Go/s en lecture.
- … vous gardez la machine sur votre bureau
- Elle tient dans un litre, pèse 1,2 kg et a une façade épurée. Au repos, le GPU consomme environ 10 W.
- … vous servez une équipe ou des agents d'IA
- Une heure à 16 utilisateurs sur gpt-oss 120B, puis deux heures à 8 utilisateurs sur Llama 3.3 70B : la vitesse est restée stable (dérive de 0,0 % et de −0,6 %), sans aucun bridage.
- … vous voulez payer moins sans changer de puce
- La 9001, avec un SSD de 4 To en PCIe 4.0, était affichée à 6 346,27 € à la boutique officielle AORUS le 8 octobre 2026, épuisée, et en stock sur Amazon.fr. Elle a la même puce et les mêmes 128 Go ; les relevés de cette page portent sur la référence 9000.
- … vos modèles occupent moins de 35 Go avec leur contexte
- La version de 64 Go, annoncée pour le 23 octobre 2026, devrait suffire (calcul tiré de notre premier guide, non mesuré sur cette version). Attendez sa disponibilité et son prix.
- … vous voulez relier plusieurs machines
- Les deux ports QSFP (200 Gb/s) sont prévus pour cet usage. GIGABYTE vend le câble séparément.
#FAQ
L'AI TOP ATOM est-elle aussi rapide qu'un DGX Spark de NVIDIA ?+
Qu'est-ce qui change concrètement entre une ATOM et une Founders Edition ?+
L'AI TOP ATOM ralentit-elle quand elle travaille longtemps ?+
Quelle référence choisir : 9000, 9001 ou 9002 ?+
Faut-il attendre la version de 64 Go ?+
Un retour, une erreur, une précision ? Faites-nous signe, ça améliore le guide pour tout le monde.