Assistant IA privé pour PME sur GB10 : mesures

Sur une GIGABYTE AI TOP ATOM (puce NVIDIA GB10, 128 Go), une pile logicielle complète (l'interface Open WebUI, le modèle gpt-oss 120B et le modèle de recherche bge-m3) démarre en 66 secondes et occupe 68 Go. Elle indexe 5 000 pages en 6 minutes, retrouve le bon document dans 86 % des cas sur 500 pages (78 % sur 5 000) et répond en 10 secondes à une personne. Pendant 200 réponses, aucun conteneur n'a envoyé de paquet vers l'extérieur. Chaque réponse coûte 0,15 Wh côté GPU.
Une PME qui veut interroger ses contrats et ses procédures avec une IA se pose vite une question : où vont mes documents ? Un assistant privé garde tout sur une machine du bureau. Il repose sur le RAG (génération augmentée par la recherche) : le système cherche d'abord les passages utiles dans vos fichiers, puis un modèle rédige la réponse. Nous avons mesuré une pile complète sur une AI TOP ATOM fournie gracieusement par GIGABYTE, avec les documents d'une entreprise fictive.
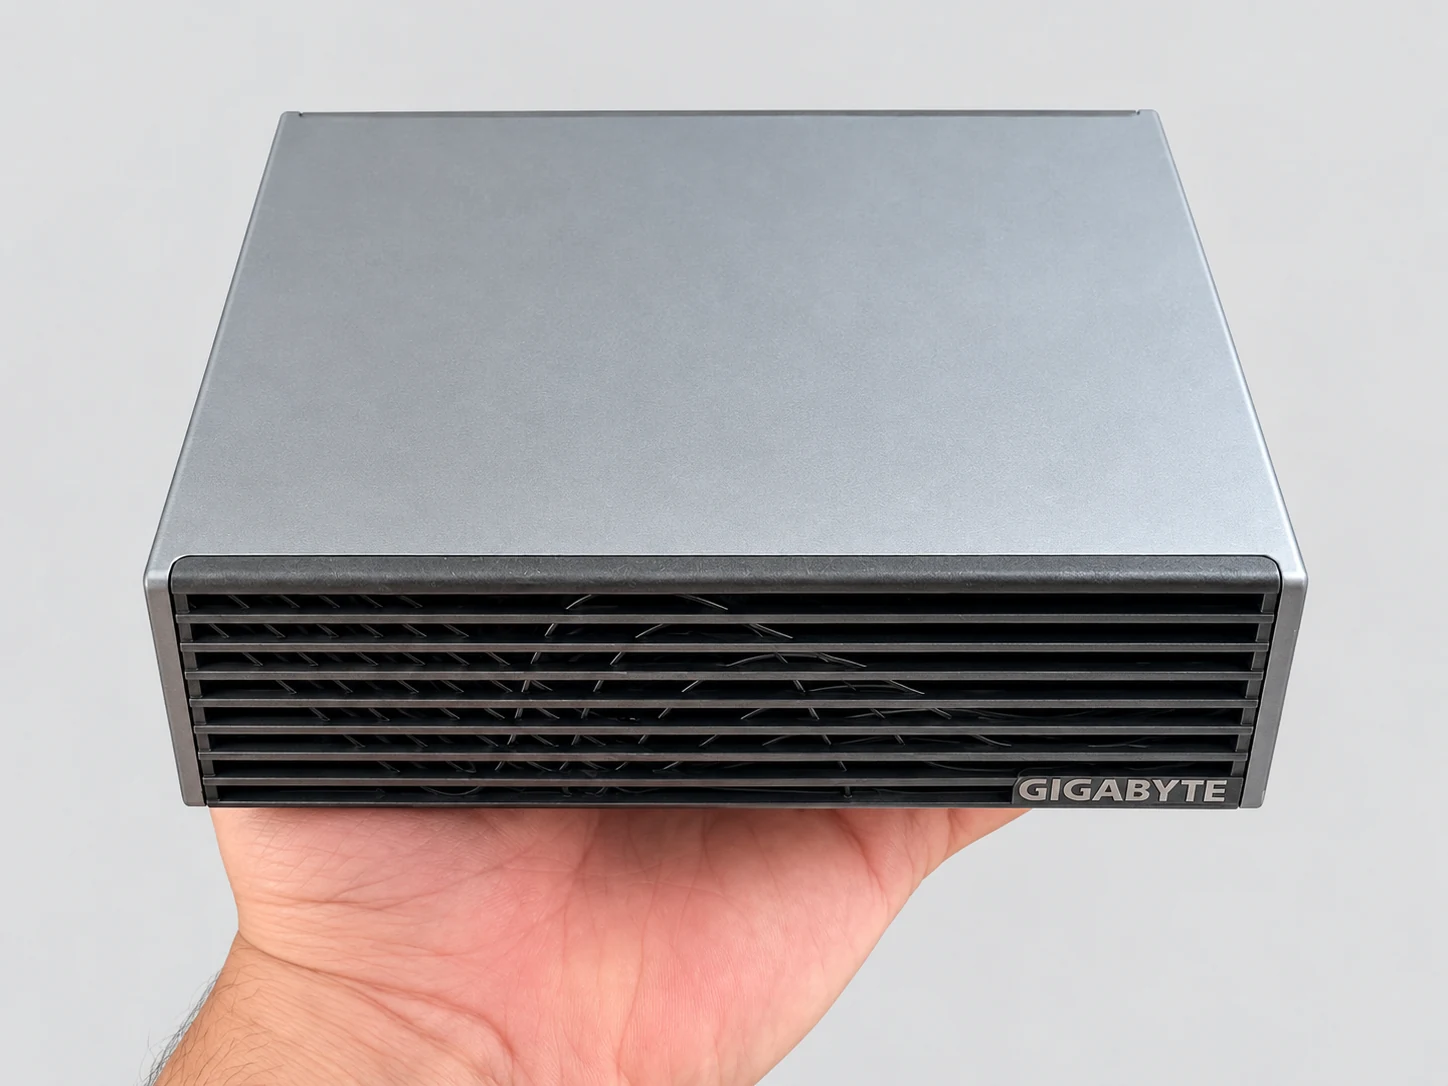
#Ce que contient la pile : trois logiciels, 68 Go
Un assistant privé se compose de trois briques, que nous avons installées dans des conteneurs Docker sur une AI TOP ATOM (référence ATAGB10-9000, DGX OS 7.5.0). Les modèles tournent avec llama.cpp, build 11430.
- Open WebUI 0.11.4
- L'interface web : comptes, import des fichiers, bases de connaissances et conversation. C'est aussi lui qui découpe les documents en extraits, 1 000 caractères avec 100 de recouvrement par défaut, et qui garde les 5 extraits les plus proches de chaque question.
- gpt-oss 120B (MXFP4)
- Le modèle qui rédige la réponse, servi par llama-server (le serveur fourni avec llama.cpp). MXFP4 est son format d'origine, déjà compressé. Il est réglé pour 10 demandes en parallèle. C'est un modèle MoE (mélange d'experts) : à chaque token, il n'utilise que 5,1 de ses 117 milliards de paramètres.
- bge-m3 (Q8_0)
- Le modèle de plongements, utilisé ici en version Q8_0 (compression à 8 bits). Il transforme chaque extrait en une suite de nombres qui représente son sens, ce qui permet de comparer une question et les extraits. Il est multilingue, donc adapté au français.
Le démarrage complet, depuis un cache disque vidé, a pris 66 secondes jusqu'à une interface prête. La pile occupe 68,0 Go de mémoire : le processus gpt-oss 120B en tient 63,6 Go côté GPU et bge-m3 0,8 Go ; le reste vient d'Open WebUI et du système.
Après le démarrage, 48,6 Go restent disponibles sur la machine. Les mémoires de ce guide sont en Go, comme les affiche Linux : 1 Go = 1 024 Mo. Notre premier guide de la série détaille la vitesse de gpt-oss 120B : 58 tokens par seconde.
#L'entreprise fictive et les 100 questions
Tes documents, ton IA : un RAG local fiable sur tes PDF, notes et mails — sans rien envoyer dans le cloud.
- Espace en ligne à vie
- PDF + fichiers
- Remboursé 30 j
Lustrelle est une PME fictive que nous avons inventée : un atelier, un entrepôt, un service après-vente et des bureaux. Ses 60 documents sont des fichiers texte au format Markdown (un texte simple avec quelques signes pour les titres et les listes). Ils traitent des ressources humaines, de la sécurité de l'atelier, des sauvegardes, des notes de frais, des retours de clients ou du plan de formation. Ils contiennent des chiffres, des noms et des conditions précis, pour que chaque réponse se vérifie.
Pour atteindre des volumes réalistes, nous avons ajouté des fiches publiques de Service-Public, comme le prévoit notre protocole. Cela donne trois bases de tailles croissantes. Les précisions de méthode de ce guide sont fixées par un avenant à notre protocole, daté du 7 octobre 2026, avant la première réponse de l'assistant. Le protocole a été figé avant la première mesure ; la méthode, la liste datée des avenants et les données de nos tableaux sont publiées sur notre page de méthode.
| Base | Fichiers | Contenu |
|---|---|---|
| 50 pages | 26 | 26 des 60 documents de Lustrelle |
| 500 pages | 114 | les 60 documents de Lustrelle et 54 fiches Service-Public |
| 5 000 pages | 701 | les 60 documents de Lustrelle et 641 fiches Service-Public |
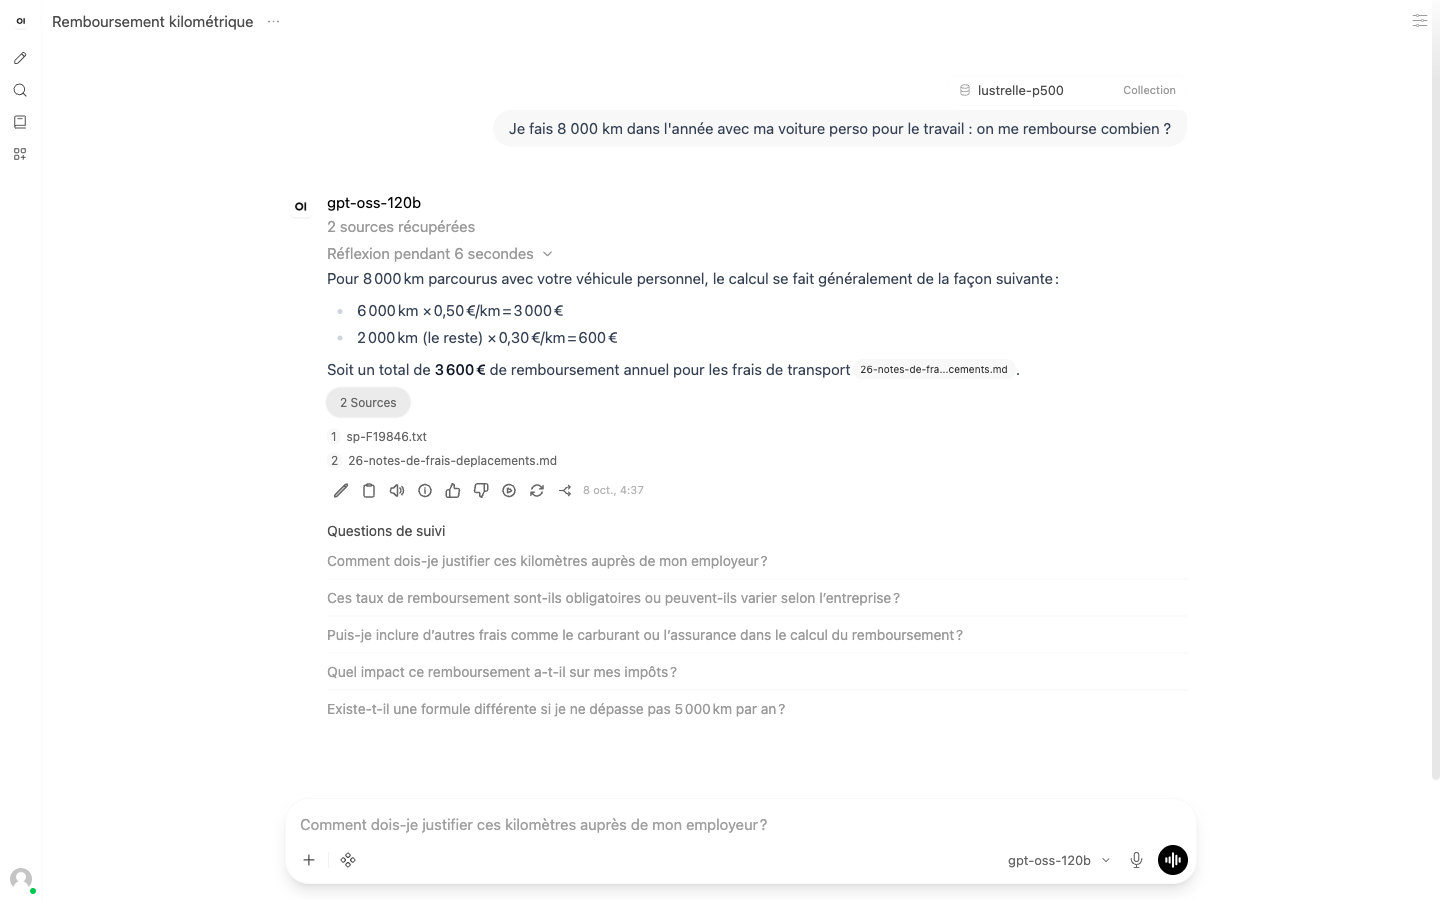
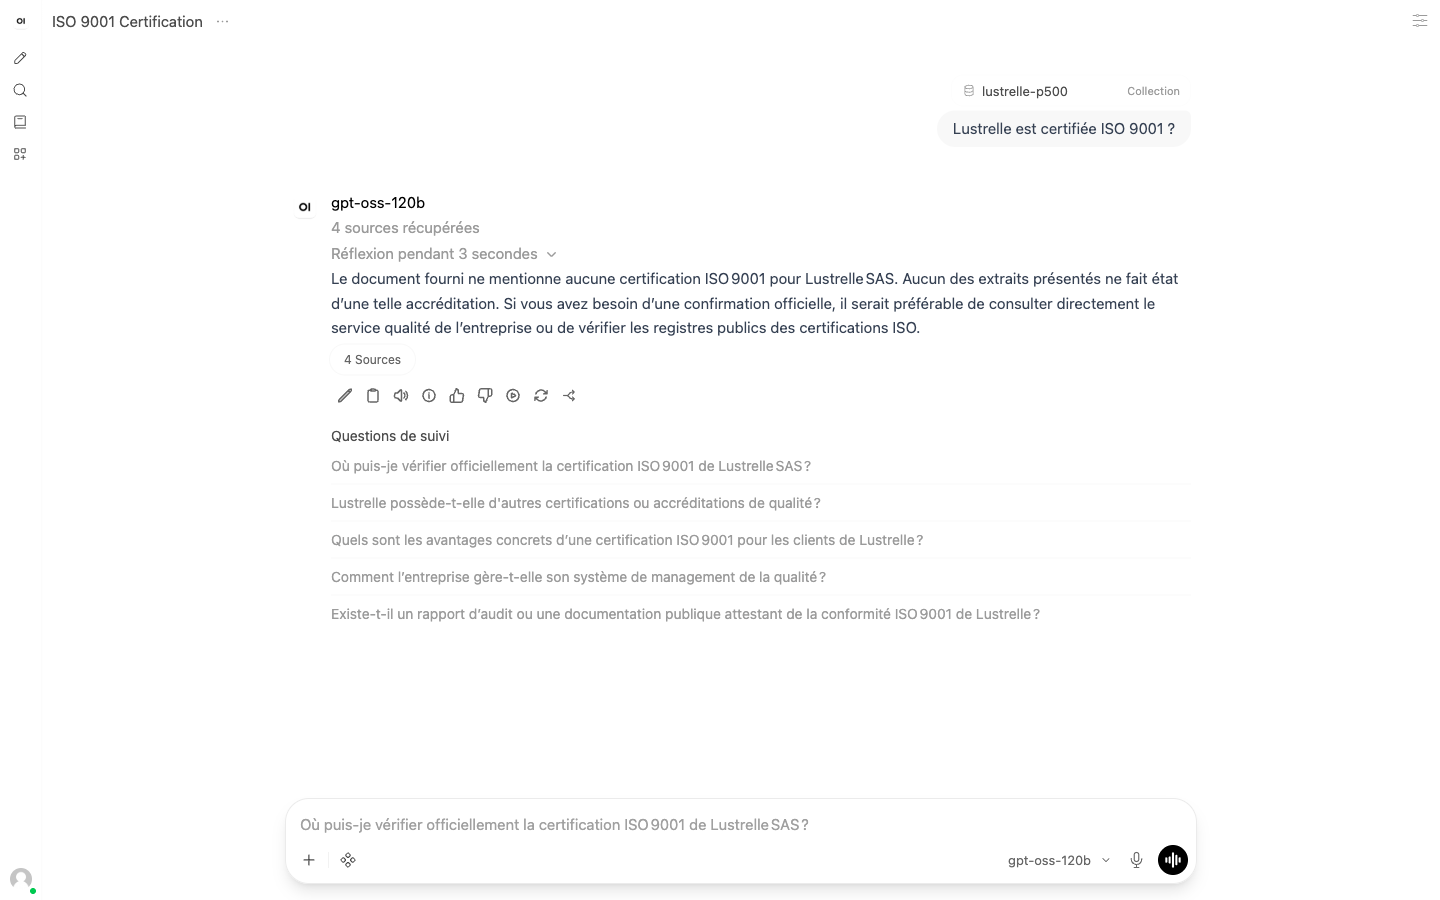
Les 100 questions sont posées telles quelles, sans reformulation. 80 d'entre elles ont leur réponse dans les documents : 50 questions de fait, 10 de procédure, 10 de chiffre et 10 de synthèse. 20 n'ont aucune réponse dans les documents : elles servent à vérifier que l'assistant l'admet au lieu d'inventer.
- Fait
- On a combien d'équipiers de première intervention incendie ? Réponse attendue : dix, désignés parmi les salariés.
- Chiffre
- La suspension Brindille de 60 cm en chêne fumé coûte combien en TTC ? Réponse attendue : 360 € TTC (348 € en chêne naturel, plus 12 € pour la finition fumée).
- Sans réponse dans les documents
- Lustrelle est certifiée ISO 9001 ? Réponse attendue : l'assistant dit que les documents ne le mentionnent pas.
#Mettre la pile en place : les commandes
La pile tient en trois conteneurs et deux réseaux Docker. Le premier réseau est « interne » : Docker n'y donne aucun accès à l'extérieur. Les deux serveurs de modèles n'y sont reliés qu'à lui. Open WebUI est relié à ce réseau interne, pour parler aux modèles, et à un second réseau, par lequel vous ouvrez l'interface dans votre navigateur.
Les commandes ci-dessous sont celles de nos essais des 7 et 8 octobre 2026, avec des chemins simplifiés. llama.cpp (build 11430) est compilé sur la machine pour la puce GB10 ; la commande de compilation figure dans le tutoriel 70B de cette série.
L'option -np 10 ouvre 10 emplacements : dix demandes peuvent avancer en même temps (le guide llama.cpp de NVIDIA en prévoit 4 par défaut). L'option -c 131072 fixe le contexte total, que les emplacements se partagent. RAG_TOP_K à 5 demande cinq extraits par question. Les variables OFFLINE_MODE, ANONYMIZED_TELEMETRY, DO_NOT_TRACK et SCARF_NO_ANALYTICS désactivent les vérifications de mise à jour, les téléchargements depuis Internet et la télémétrie d'Open WebUI. Le découpage reste celui d'Open WebUI par défaut, réglable dans son interface.
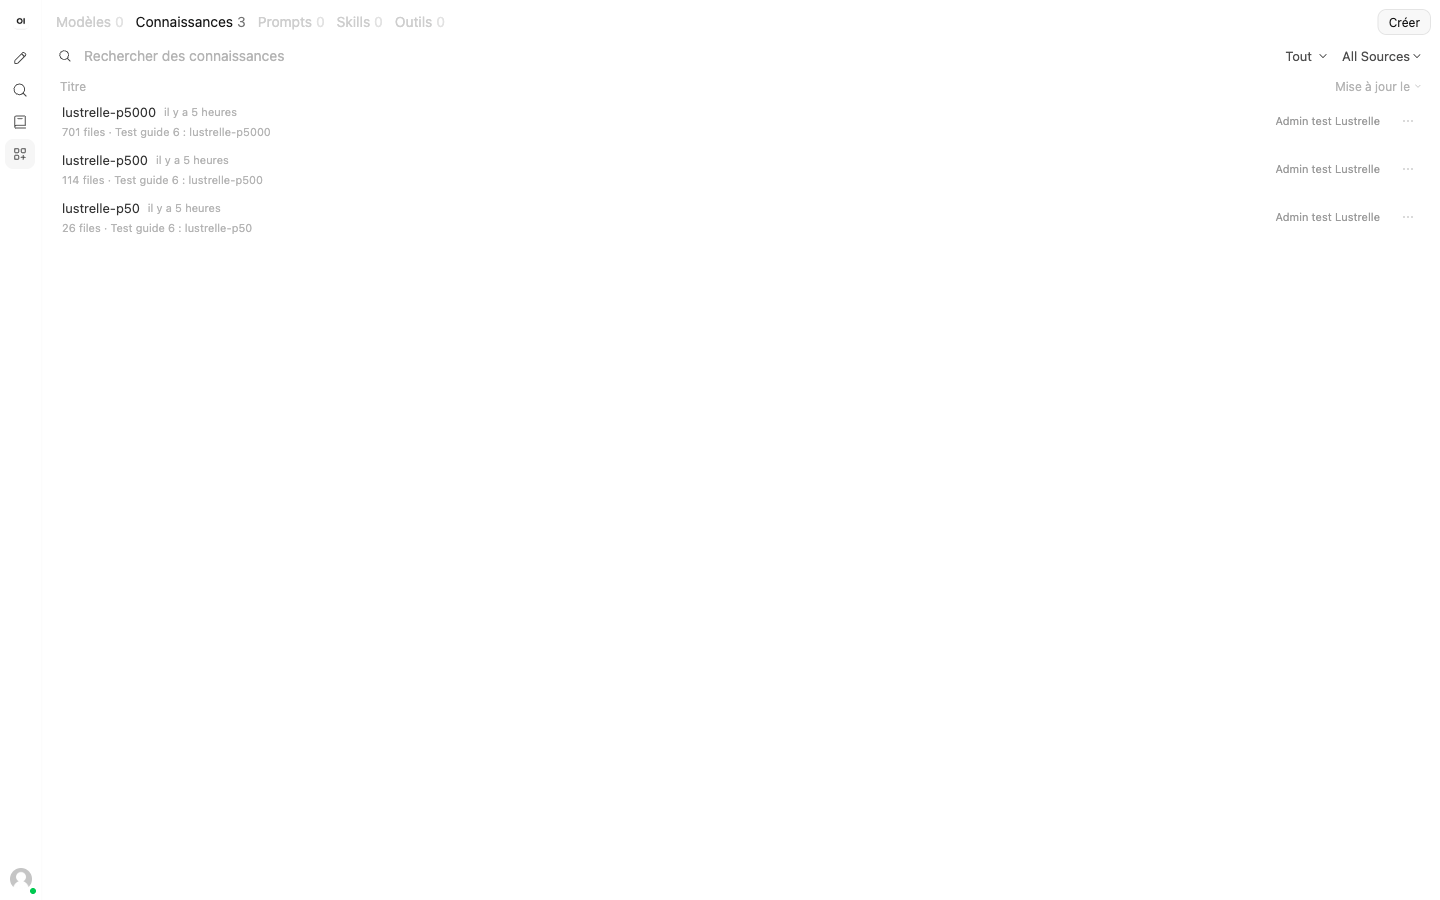
- 01Ouvrez Open WebUIAllez sur http://127.0.0.1:3100 et créez le compte administrateur. Choisissez gpt-oss-120b comme modèle.
- 02Créez une base de connaissancesOuvrez la rubrique Connaissances, créez une base et ajoutez vos fichiers. Open WebUI lit chaque fichier, le découpe et calcule ses plongements.
- 03Interrogez la baseDans une conversation, tapez le signe dièse suivi du nom de la base, puis posez votre question. La réponse s'affiche avec ses sources.
Nos mesures passent par l'API d'Open WebUI, ce qui permet de les rejouer par script. Voici les mêmes appels que dans notre script de mesure (écrit en Python), transcrits avec curl et jq.
#Indexer 50, 500 et 5 000 pages
Indexer, c'est lire chaque fichier, le découper en extraits, calculer les plongements avec bge-m3 et ranger le tout dans la base. Notre script envoie les fichiers 4 à la fois et chronomètre jusqu'au dernier fichier traité. Aucun fichier n'a échoué.
| Base | Fichiers | Durée | Échecs |
|---|---|---|---|
| 50 pages | 26 | 9,2 s | 0 |
| 500 pages | 114 | 46,8 s | 0 |
| 5 000 pages | 701 | 365,9 s (6,1 min) | 0 |
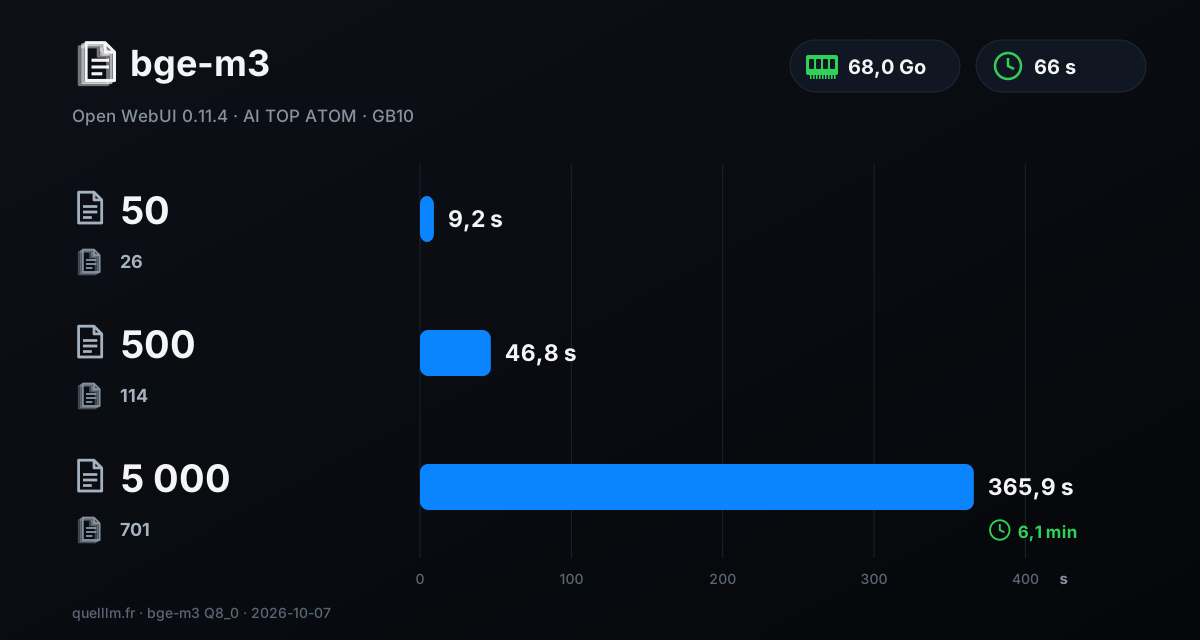
5 000 pages sont prêtes en un peu plus de 6 minutes, soit environ 1,9 fichier par seconde. Réindexer un fonds de 5 000 pages prend donc moins de 7 minutes. Pendant cette indexation, le GPU a consommé 5,4 Wh.
#Le bon document est-il retrouvé ?
Avant la qualité des réponses, il faut savoir si l'assistant va chercher au bon endroit. Notre indicateur automatique, « bon document retrouvé », compte les questions pour lesquelles au moins un des documents attendus figure parmi les sources renvoyées par Open WebUI. Il porte sur les 80 questions qui ont une réponse dans les documents. Un script le calcule ; ce n'est pas une note de qualité et il ne dit pas si la réponse est juste.
| Base | Bon document retrouvé | Réponses reçues sans erreur | Durée médiane d'une réponse |
|---|---|---|---|
| 500 pages | 86 % (69 questions sur 80) | 100 sur 100 | environ 40 s |
| 5 000 pages | 78 % (62 questions sur 80) | 100 sur 100 | environ 42 s |
Avec environ six fois plus de fichiers (701 contre 114), le bon document reste retrouvé dans 78 % des cas. Les 100 réponses de chaque base sont arrivées sans erreur technique ni réponse vide, chacune avec la liste de ses sources. Cette liste permet de vérifier : un clic sur le bouton des sources, et l'on voit les fichiers utilisés.
#Combien de personnes en même temps ?
Nous avons simulé 1, 5 puis 10 utilisateurs qui interrogent la pile en même temps. Ils sont sur un Mac relié à l'ATOM par un tunnel SSH qui passe par Tailscale, un réseau privé. Chaque utilisateur pose 6 questions à la suite, sans pause entre deux questions, et les réponses arrivent en flux. Nous relevons le temps du premier mot et le temps de la réponse complète, en médiane. Chaque série compte 6, 30 ou 60 requêtes ; aucune n'a échoué.
| Utilisateurs | Base | Premier mot | Réponse complète |
|---|---|---|---|
| 1 | 500 pages | 9,0 s | 9,6 s |
| 1 | 5 000 pages | 9,9 s | 10,2 s |
| 5 | 500 pages | 33,1 s | 38,4 s |
| 5 | 5 000 pages | 39,3 s | 44,7 s |
| 10 | 500 pages | 52,4 s | 63,5 s |
| 10 | 5 000 pages | 50,2 s | 64,8 s |
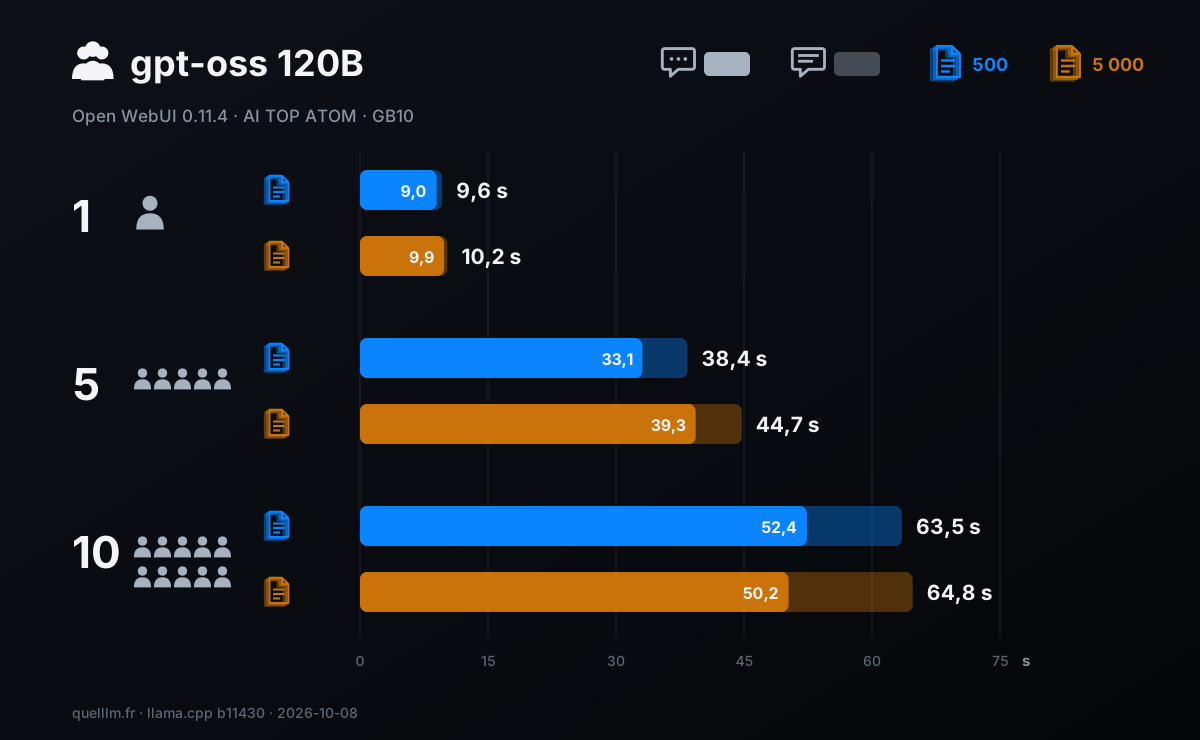
Pour une personne seule, la réponse complète arrive en 9,6 s sur 500 pages et en 10,2 s sur 5 000 pages. Quand 5 personnes posent leur question en même temps, la médiane passe à 38 s et 45 s. À 10 personnes, elle est d'environ une minute : 63,5 s et 64,8 s. La taille de la base change peu ces durées : de 500 à 5 000 pages, la différence va de 0,6 à 6,4 secondes.
Le premier mot arrive après la phase de réflexion de gpt-oss 120B : Open WebUI affiche alors « Réflexion pendant 6 secondes » ou une durée proche. Cette phase s'ajoute à la lecture des extraits et se partage entre les utilisateurs. Notre test est exigeant : chaque utilisateur enchaîne ses questions sans temps de lecture, alors qu'une personne réelle lit la réponse avant de poser la suivante.
#Dimensionner pour 5 à 20 personnes
Avec 10 utilisateurs actifs en continu, la pile termine 60 réponses en 441 secondes sur la base de 500 pages : environ 8 réponses par minute. Voici un calcul à partir de cette mesure. Une équipe de 20 personnes, dont chacune pose en moyenne une question toutes les 5 minutes, génère 4 questions par minute, soit la moitié de ce débit. C'est un ordre de grandeur et non une mesure : vos usages réels peuvent différer.
- Jusqu'à 5 personnes
- Une réponse en 10 s quand une personne interroge ; environ 40 s quand les 5 interrogent à la même seconde.
- De 5 à 10 personnes
- Environ une minute pour une réponse complète quand les 10 interrogent en continu, sans aucune erreur. Le serveur est réglé pour 10 demandes en parallèle.
- De 10 à 20 personnes
- Nous n'avons pas mesuré plus de 10 utilisateurs simultanés. Le calcul ci-dessus suggère que 20 personnes aux usages habituels restent sous le débit mesuré.
#Confidentialité : ce que nous avons vérifié
Un assistant privé n'a de sens que si les documents restent chez vous. Nous avons donc vérifié le trafic réseau. Pendant les 200 réponses, 100 sur chaque base, nous avons capturé les paquets des deux réseaux Docker de la pile avec tcpdump, puis nous avons listé toutes les adresses rencontrées.
Résultat : aucun conteneur de la pile n'a envoyé de paquet vers une adresse extérieure. Les seules adresses rencontrées sont celles des conteneurs et de la passerelle de la machine hôte, ainsi que des adresses de multidiffusion et de diffusion locale (messages de découverte du réseau local). Open WebUI est relié à un réseau d'accès, et pourtant aucune adresse extérieure n'apparaît. Les deux serveurs de modèles, eux, sont dans un réseau que Docker coupe de l'extérieur.
#Énergie : 0,15 Wh par réponse
Nous avons relevé la puissance du GPU une fois par seconde pendant les 100 réponses de chaque base, 4 questions à la fois. Sur 500 pages, le GPU a travaillé 18,0 minutes à 50,5 W en moyenne, avec une pointe à 68,1 W : 15,2 Wh, soit 0,15 Wh par réponse. Sur 5 000 pages, 50,7 W et 15,4 Wh : le même résultat, 0,15 Wh par réponse.
| Situation | Durée | Puissance moyenne du GPU | Énergie du GPU |
|---|---|---|---|
| Repos, aucune tâche | 30 min | 10,4 W | — |
| 100 réponses, base de 500 pages, 4 à la fois | 18,0 min | 50,5 W | 15,2 Wh, soit 0,15 Wh par réponse |
| 100 réponses, base de 5 000 pages, 4 à la fois | 18,2 min | 50,7 W | 15,4 Wh, soit 0,15 Wh par réponse |
| Indexation des 5 000 pages | 6,1 min | 53,2 W | 5,4 Wh |
Au tarif EDF Tarif Bleu Base (20,01 centimes par kWh TTC, grille applicable au 1er août 2026, abonnement non compté), 1 000 réponses représentent 0,15 kWh, soit 3 centimes. Ces chiffres ne comptent que le GPU, tel que la puce le rapporte : selon NVIDIA, la puissance affichée par nvidia-smi est celle du GPU seul. Le processeur, la mémoire, le SSD et l'alimentation ne sont pas inclus. Un autre guide de la série détaille la consommation sur la durée.
#La qualité des réponses, notée une par une
Un indicateur automatique ne dit pas si une réponse est juste. Les 100 réponses obtenues sur la base de 500 pages ont donc été notées une par une. À la demande de l'auteur, cette notation a été faite par Claude, le modèle d'IA d'Anthropic, et non par le modèle qui répond (gpt-oss 120B).
Pour chaque question, Claude disposait de la réponse attendue, du document source et de la grille ci-dessous. La note va de 0 à 2 et juge le fond (chiffres, dates, noms, conditions), pas la formulation. Une source absente ne change pas la note ; en cas de doute, la note la plus basse est retenue.
| Note | Question avec réponse dans les documents | Question sans réponse dans les documents |
|---|---|---|
| 2 | Correcte et complète : l'information principale est exacte, rien de faux n'est ajouté. | L'assistant dit qu'il ne trouve pas l'information dans les documents, sans rien inventer. |
| 1 | Partielle ou incomplète : l'essentiel est juste, mais il manque un élément important, ou un détail secondaire est faux. | Il hésite ou répond à côté, sans inventer de réponse. |
| 0 | Fausse ou inventée : l'information principale est fausse, contredit les documents ou n'a aucun rapport. | Il invente une réponse : un chiffre, une date, un nom ou une règle absents des documents. |
| Type de question | Questions | Score | Justes et complètes |
|---|---|---|---|
| Synthèse : croiser plusieurs documents | 10 | 95 % | 9 |
| Fait précis | 50 | 80 % | 38 |
| Chiffre ou calcul | 10 | 80 % | 8 |
| Procédure : toutes les étapes et tous les délais | 10 | 60 % | 3 |
| Sans réponse dans les documents | 20 | 68 % | 12 |
| Ensemble | 100 | 77 % | 70 |
Les questions de synthèse demandent de croiser plusieurs documents et de retenir la règle la plus récente. L'assistant y répond juste et complètement 9 fois sur 10. La plupart des réponses fausses viennent de la recherche du document, pas de la rédaction.
Quand un document attendu figure parmi les sources (69 questions sur 80), 57 réponses sont justes et complètes et le score atteint 88 %. Quand il manque (11 questions), la réponse est le plus souvent fausse. Cette recherche dépend des réglages d'Open WebUI (découpage des documents, nombre d'extraits), que nous n'avons pas fait varier : c'est le premier levier à ajuster sur votre installation.
Sur les 20 questions dont la réponse n'est pas dans les documents, l'assistant le dit clairement 12 fois. Dans 5 cas, il ajoute une information qui n'en vient pas : une estimation chiffrée, une confusion entre deux notions ou un numéro mal attribué. Ouvrir les sources affichées sous la réponse permet de repérer ces cas.
Chaque note est publiée avec sa justification, la question et la réponse attendue, dans un fichier CSV de notre page de données. Les 100 réponses sur la base de 5 000 pages ne sont pas notées : seul l'indicateur « bon document retrouvé » les concerne.
#Pour qui l'ATOM est le bon choix
- Une PME de 5 à 20 personnes qui veut un assistant sur ses documents
- Tout tient sur une machine : 68 Go de mémoire, 66 secondes de démarrage, 5 000 pages indexées en 6 minutes et une réponse en 10 secondes quand une personne interroge.
- Un cabinet ou un service qui manipule des documents sensibles
- Pendant nos 200 réponses, aucun paquet n'est parti vers l'extérieur. Dans notre montage, les documents restent sur la machine.
- Une équipe qui veut partager un assistant
- 10 utilisateurs actifs en continu ont tous reçu leur réponse, en environ une minute, sans aucune erreur.
- Un intégrateur ou un service informatique
- La pile repose sur des briques ouvertes : Docker, Open WebUI, llama.cpp et des modèles à poids ouverts ; seuls le pilote, CUDA et les conteneurs de NVIDIA sont propriétaires. Open WebUI offre aussi une API que votre logiciel peut appeler.
Séparons la plateforme et le constructeur. La puce NVIDIA GB10 permet ces résultats : ses 128 Go de mémoire unifiée logent un modèle de 117 milliards de paramètres (gpt-oss 120B) avec son contexte et un modèle de plongements, et sa bande passante est annoncée à 273 Go/s.
GIGABYTE apporte son propre châssis d'un litre (1,2 kg) et son refroidissement à deux ventilateurs : pendant les 100 réponses sur 5 000 pages, le GPU est resté à 66 °C en moyenne et 72 °C au plus, sans aucun bridage signalé.
Prix relevés le 8 octobre 2026 pour l'ATAGB10-9001 (128 Go, SSD de 4 To en PCIe 4.0) : 6 346,27 € TTC à la boutique officielle AORUS, où elle était épuisée ; elle était en stock sur Amazon.fr. Nous avons mesuré la référence ATAGB10-9000, dont le SSD est en PCIe 5.0. Les prix GB10 bougent chaque semaine : vérifiez-les avant d'acheter.
#Ce que nous n'avons pas mesuré
- Une notation humaine
- Les réponses ont été notées par Claude, un modèle d'IA, et non par une personne. La base de 5 000 pages n'est pas notée. Chaque note est publiée avec sa justification pour être contrôlée.
- Des documents réels
- Notre corpus est fictif, rédigé en français, aux formats Markdown et texte. Les PDF, les documents Word, les scans et les tableaux ne sont pas mesurés.
- Plus de 10 utilisateurs
- Le serveur est réglé pour 10 demandes en parallèle. Nous n'avons pas mesuré au-delà, ni avec des comptes distincts : un seul compte de test a servi.
- D'autres réglages
- Nous n'avons pas fait varier le découpage (réglage par défaut d'Open WebUI) ni le nombre d'extraits (fixé à 5). D'autres réglages peuvent modifier le taux de bon document retrouvé.
- Énergie
- Elle concerne le GPU seul.
Mises à jour et corrections : notation des réponses ajoutée le 8 octobre 2026 ; chaque correction sera datée.
#FAQ
Combien de personnes peuvent utiliser l'assistant en même temps ?+
Mes documents quittent-ils la machine ?+
Combien de pages peut-on indexer, et en combien de temps ?+
Faut-il la version 128 Go de l'ATOM ?+
Comment vérifier une réponse de l'assistant ?+
Combien coûte une réponse en électricité ?+
Un retour, une erreur, une précision ? Faites-nous signe, ça améliore le guide pour tout le monde.