GB10, Ryzen AI Max+ 395 ou Mac : qui va le plus vite ?
À moteur identique (llama.cpp), l'AI TOP ATOM, avec sa puce NVIDIA GB10, lit les prompts de 2,1 à 2,8 fois plus vite que le Ryzen AI Max+ 395 et 23 % plus vite que le Mac M5 Max sur le modèle de référence publié. En écriture, elle est au niveau du Ryzen (de 4 à 15 % devant selon le modèle). Le Mac M5 Max écrit environ deux fois plus vite sur un petit modèle dense : 119,9 contre 59,4 tok/s (tokens par seconde).
Trois familles de machines offrent 128 Go de mémoire pour l'IA locale : le GB10 de NVIDIA, dont l'AI TOP ATOM de GIGABYTE est une version, le Ryzen AI Max+ 395 d'AMD (nom de code Strix Halo) et le Mac M5 Max d'Apple. Nous avons mesuré notre AI TOP ATOM, fournie gracieusement par GIGABYTE, avec les mêmes commandes que les mesures publiées pour les deux autres, version du logiciel et date à l'appui. Voici où chacune excelle et quel achat convient à quel usage.
#Comment avons-nous comparé trois machines ?
Pour comparer les références publiées du Ryzen AI Max+ 395 et du Mac aux mesures de l'ATOM, nous avons repris le format exact de mesures déjà publiées. Le premier test fait lire 512 tokens (un token est un morceau de mot) à la machine, puis lui en fait écrire 128 (« pp512 » et « tg128 » dans llama-bench, l'outil de mesure de llama.cpp, un moteur open source très répandu pour les modèles locaux).
Ce test a été publié pour un Mac M5 Max dans la discussion n° 4167 de llama.cpp, et par kyuz0, un contributeur indépendant, pour un Framework Desktop équipé du Ryzen AI Max+ 395 et de 128 Go. Le second test mesure la vitesse quand 32 768 tokens sont déjà en mémoire. C'est celui de la discussion n° 16578 de llama.cpp, et kyuz0 le publie aussi pour le Ryzen.
Notre protocole a été figé le 6 octobre 2026 à 13 h 30, avant la première mesure. Un avenant du même jour, à 23 h 45, a ajouté ce format de comparaison.
Les mesures de lecture à 512 tokens et d'écriture à 128 tokens datent du 7 octobre à 22 h 38 : cinq répétitions par modèle, llama.cpp build 11430, attention rapide (Flash Attention) activée comme dans les mesures de kyuz0, machine sans autre travail en cours. Les mesures à 32 768 tokens datent du 6 octobre. La méthode, les empreintes des fichiers et les données de nos tableaux sont publiées sur notre page de méthode.
Les vitesses sont en tokens par seconde (tok/s). Un token est un morceau de mot : en français, il vaut environ deux tiers de mot. Les tailles de mémoire sont en Go (1 Go = 1 024 Mo, comme l'affiche Linux) ; les débits de mémoire en Go/s sont ceux annoncés par les fabricants, en unités décimales. Voici les commandes utilisées sur l'ATOM :
Une précaution : le build est le numéro de version de llama.cpp, et les trois machines n'utilisent pas le même. Le Ryzen a été mesuré avec les builds b9187 ou b9193 en mai 2026, le Mac avec le b10621 en août, l'ATOM avec le b11430 en octobre.
Un build plus récent peut aller plus vite. Pour rester honnêtes, nous donnons aussi, pour le test à 32 768 tokens, nos chiffres avec le build 7941 de février 2026, plus ancien que celui du Ryzen (aucune mesure publiée pour le Mac à ce format).
#Trois machines à 128 Go : qu'est-ce qui change ?
Profite de notre expérience et d’un parcours guidé pour choisir les outils adaptés à ton Mac et utiliser ton IA au quotidien.
- Espace en ligne à vie
- PDF + fichiers
- Remboursé 30 j
Le GB10 de NVIDIA réunit 20 cœurs Arm et un GPU Blackwell autour de 128 Go de mémoire unifiée (partagée par le processeur et le GPU), dont la bande passante est annoncée à 273 Go/s. Le Ryzen AI Max+ 395 d'AMD (nom de code Strix Halo) partage lui aussi 128 Go entre le processeur et le GPU, avec environ 256 Go/s en théorie. Le M5 Max d'Apple va jusqu'à 128 Go, avec 614 Go/s et un GPU de 40 cœurs.
| Machine | Puce | Mémoire | Bande passante |
|---|---|---|---|
| AI TOP ATOM (GIGABYTE) | NVIDIA GB10 : 20 cœurs Arm et GPU Blackwell | 128 Go LPDDR5x | 273 Go/s |
| Ryzen AI Max+ 395 (chiffres publiés sur un Framework Desktop) | AMD Strix Halo | 128 Go LPDDR5x | environ 256 Go/s (théorie) |
| Mac M5 Max | Apple M5 Max : GPU de 40 cœurs | jusqu'à 128 Go | 614 Go/s |
Pour écrire chaque token, la puce relit en mémoire les poids actifs du modèle (les paramètres utilisés à cet instant) : l'écriture suit donc la bande passante, et la lecture, qui traite beaucoup de tokens à la fois, la puissance de calcul du GPU.
Le GB10 et le Ryzen ont une bande passante voisine : leurs vitesses d'écriture le sont aussi. Le M5 Max offre 2,25 fois la bande passante de l'ATOM (614 contre 273 Go/s) : sur le seul modèle dense publié, llama 7B, il écrit environ deux fois plus vite.
À notre connaissance, toutes les machines GB10 de 128 Go partagent la même puce NVIDIA. Les vitesses de ce guide sont donc celles de la plateforme. Ce que GIGABYTE apporte en plus, c'est le châssis d'un litre (1,2 kg), le refroidissement, la finition et les références commerciales.
Pour vérifier que notre unité donne bien les vitesses de la plateforme, nous avons rejoué le tableau publié par le projet llama.cpp pour le DGX Spark de NVIDIA, la machine de référence de la plateforme (build 7941, février 2026). Sur six modèles et 60 points de mesure, nos lectures sont à +0,3 % en médiane (de −1,8 % à +2,3 %) et nos écritures à −2,8 % en médiane (de −4,3 % à −0,3 %) : les deux machines sont au même niveau.
#Qui lit le plus vite ?
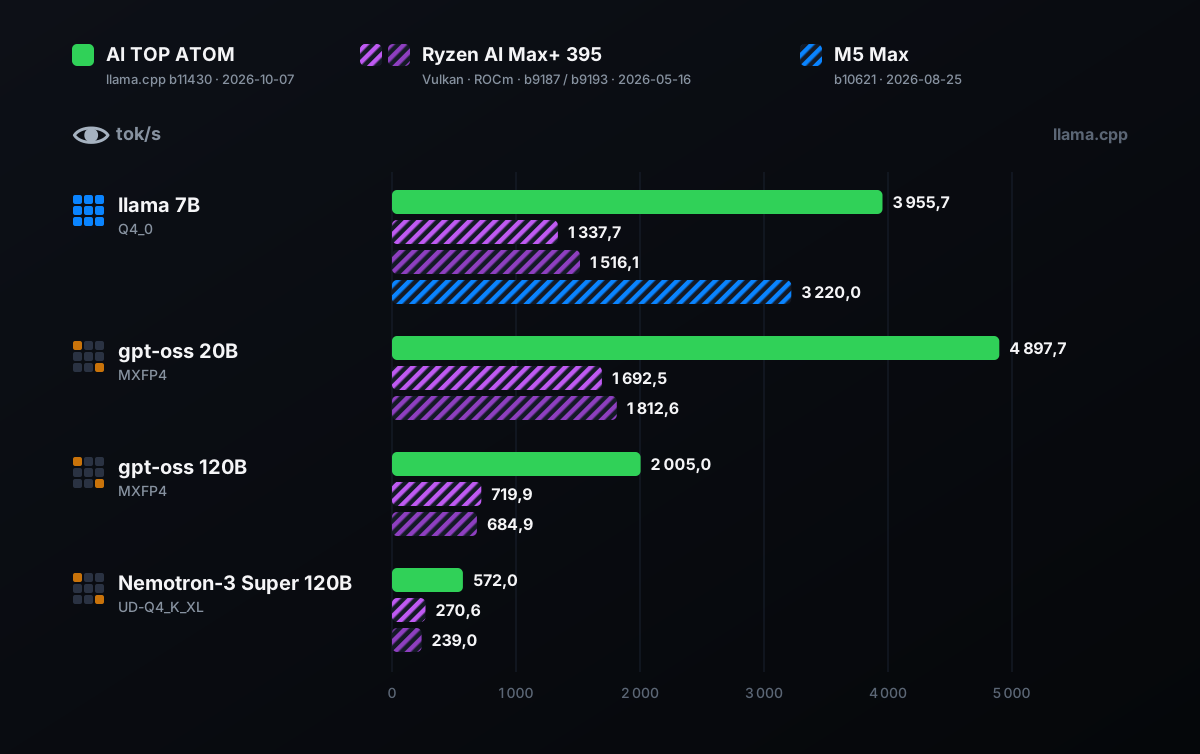
La lecture est le point fort de l'ATOM. Le tableau reprend les quatre modèles que nous avons pu comparer exactement, c'est-à-dire avec le même modèle et la même compression pour chaque machine. « llama 7B » désigne Llama 2 en 7 milliards de paramètres, le modèle de référence de ces publications : c'est un modèle dense (il utilise tous ses paramètres à chaque token), alors que les trois autres sont des modèles MoE (ils n'en activent qu'une partie).
| Modèle | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / meilleur Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 3 955,7 | 1 337,7 | 1 516,1 | 3 220,0 | × 2,6 |
| gpt-oss 20B (MXFP4) | 4 897,7 | 1 692,5 | 1 812,6 | — | × 2,7 |
| gpt-oss 120B (MXFP4) | 2 005,0 | 719,9 | 684,9 | — | × 2,8 |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 572,0 | 270,6 | 239,0 | — | × 2,1 |
Sur ces quatre modèles, l'ATOM lit de 2,1 à 2,8 fois plus vite que la meilleure des deux piles logicielles du Ryzen AI Max+ 395 (Vulkan et ROCm sont deux façons de faire calculer le GPU d'AMD). Sur gpt-oss 120B, elle lit 2 005 tokens par seconde : un prompt de 2 000 tokens, soit environ 1 300 mots, est absorbé en une seconde.
Face au Mac, nous n'avons qu'un point de comparaison publié au format llama-bench : le modèle de référence de la discussion n° 4167 de llama.cpp sur les puces Apple, llama 7B (Llama 2 en 7 milliards de paramètres) en Q4_0. L'ATOM y lit 3 955,7 tokens par seconde, contre 3 220,0 pour le M5 Max : 23 % de plus.
Avec Ollama (un outil qui lance des modèles en local), sur un document d'environ 17 000 tokens, notre premier guide de la série mesure 1 816 tok/s sur gpt-oss 120B pour l'ATOM, contre 1 388 pour un MacBook Pro M5 Max mesuré par un lecteur, sur un texte proche mais non identique (16 850 tokens pour l'ATOM, 16 689 pour le Mac) : 31 % de plus.
Pourquoi l'ATOM lit-elle si vite ? La lecture est surtout du calcul, et le GPU Blackwell du GB10 possède des cœurs dédiés aux calculs d'IA (les « Tensor Cores » de NVIDIA). C'est le critère qui compte pour un rapport de cinquante pages, un dépôt de code, ou un agent qui relit son historique avant chaque réponse.
Deux précautions de lecture. D'abord, les builds diffèrent (10621 pour le Mac, 11430 pour l'ATOM) : prenez l'écart de 23 % comme un ordre de grandeur. Ensuite, les deux plus petits modèles (llama 7B et gpt-oss 20B) varient de 3 à 5 % d'une répétition à l'autre, car ce test dure environ un dixième de seconde. Deux séries distinctes donnent pourtant des moyennes à 1 % près : 3 955,7 et 3 920,2 pour llama 7B, 4 897,7 et 4 905,2 pour gpt-oss 20B.
#Qui écrit le plus vite ?
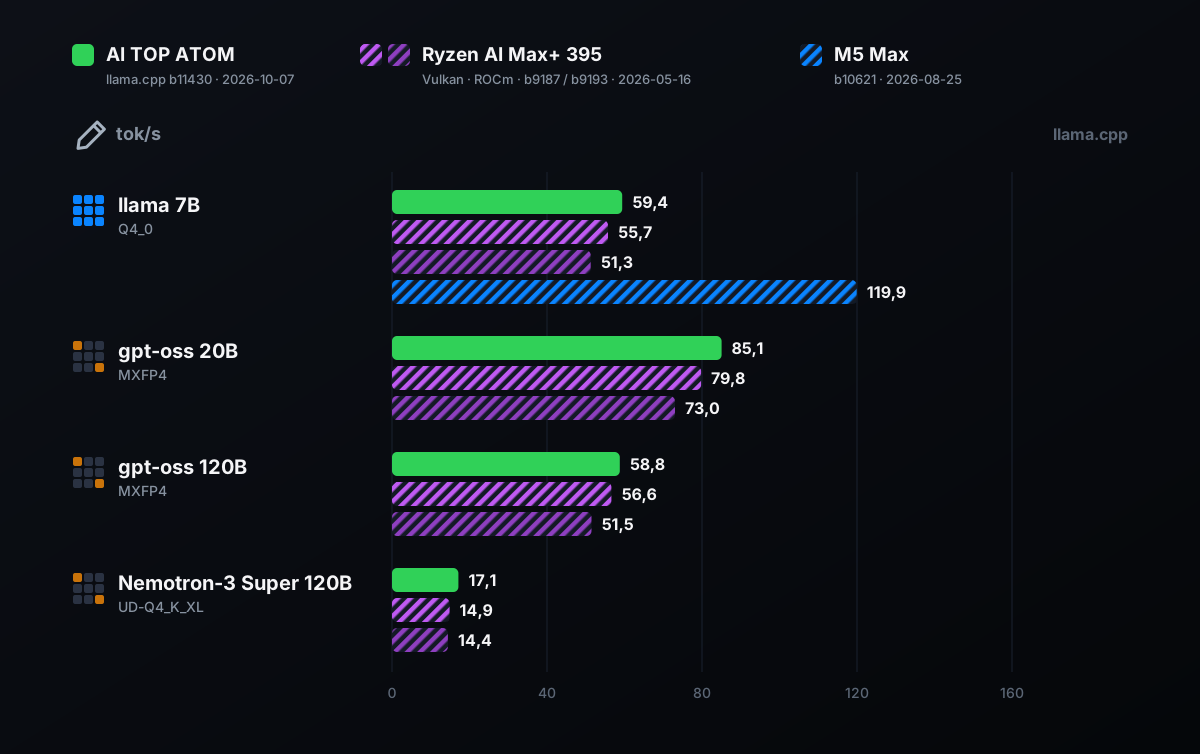
L'écriture est le rythme d'affichage de la réponse. Elle suit la bande passante de la mémoire, qui diffère d'une machine à l'autre.
| Modèle | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / meilleur Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 59,4 | 55,7 | 51,3 | 119,9 | +7 % |
| gpt-oss 20B (MXFP4) | 85,1 | 79,8 | 73,0 | — | +7 % |
| gpt-oss 120B (MXFP4) | 58,8 | 56,6 | 51,5 | — | +4 % |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 17,1 | 14,9 | 14,4 | — | +15 % |
Face à la meilleure pile logicielle du Ryzen AI Max+ 395, l'ATOM écrit de 4 à 7 % plus vite sur trois modèles, et 15 % plus vite sur Nemotron-3 Super 120B. C'est un niveau proche : les deux mémoires ont une bande passante voisine, et les builds diffèrent.
Sur gpt-oss 120B, un modèle de 117 milliards de paramètres, l'ATOM écrit 58,8 tokens par seconde sur 128 tokens (58,0 sur 32 tokens dans notre premier guide), ce qui est très fluide pour une conversation ; le Ryzen en écrit 56,6 au mieux.
Le Mac M5 Max écrit plus vite, environ deux fois plus sur un petit modèle dense (119,9 contre 59,4 tokens par seconde), grâce à sa mémoire à 614 Go/s, soit 2,25 fois celle de l'ATOM.
Sur un modèle dense, le logiciel peut accélérer l'écriture. Avec un petit modèle « brouillon » qui propose des tokens que le grand modèle valide d'un coup (le décodage spéculatif), Llama 3.3 70B passe sur l'ATOM de 4,7 à 12 tokens par seconde sur du texte français (8 mots d'avance), et jusqu'à 18,7 sur du code (16 mots d'avance) : de 2,6 à 4 fois plus vite (llama-server b11430, brouillon Llama 3.2 1B, 6 et 7 octobre 2026). Cette technique existe aussi sur les autres machines ; nous ne l'y avons pas mesurée.
#Que se passe-t-il avec un long document ?
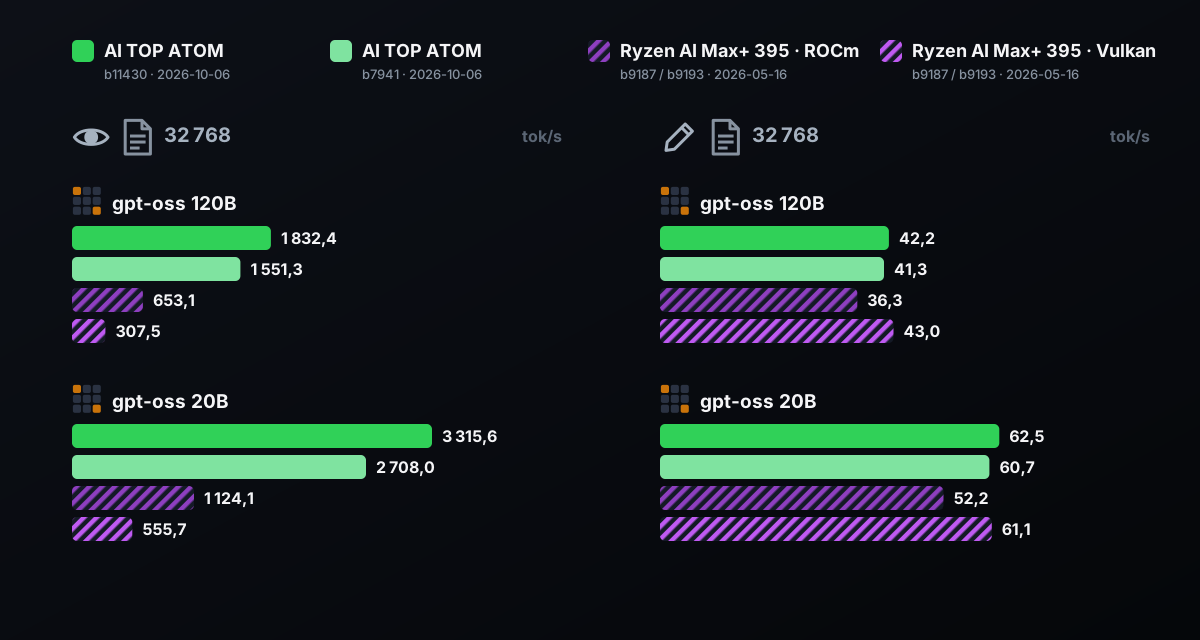
Plus le texte déjà présent est long, plus la suite ralentit. Le test à grand contexte mesure la lecture et l'écriture quand 32 768 tokens sont déjà en mémoire, soit une cinquantaine de pages. Le tableau compare l'ATOM au Ryzen AI Max+ 395 sur les deux modèles gpt-oss, avec deux builds pour l'ATOM. À notre connaissance, il n'existe pas de mesure publiée au même format pour le Mac.
| Modèle | Machine et pile | Lecture à 32 768 | Écriture à 32 768 |
|---|---|---|---|
| gpt-oss 120B | AI TOP ATOM, build 11430 | 1 832,4 | 42,2 |
| gpt-oss 120B | AI TOP ATOM, build 7941 | 1 551,3 | 41,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, ROCm | 653,1 | 36,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, Vulkan | 307,5 | 43,0 |
| gpt-oss 20B | AI TOP ATOM, build 11430 | 3 315,6 | 62,5 |
| gpt-oss 20B | AI TOP ATOM, build 7941 | 2 708,0 | 60,7 |
| gpt-oss 20B | Ryzen AI Max+ 395, ROCm | 1 124,1 | 52,2 |
| gpt-oss 20B | Ryzen AI Max+ 395, Vulkan | 555,7 | 61,1 |
Avec gpt-oss 120B, l'ATOM lit 1 832 tokens par seconde à 32 768 tokens de contexte : 2,8 fois plus vite que le Ryzen AI Max+ 395 en ROCm (653) et 6 fois plus vite qu'en Vulkan (308). Avec le build 7941, plus ancien que celui du Ryzen, l'avance reste de 2,4 fois et de 5 fois. Avec gpt-oss 20B et le build 11430, l'avance est de 2,9 et 6,0 fois.
En écriture à 32 768 tokens, l'ATOM (42,2 tok/s sur gpt-oss 120B) est au niveau de la meilleure pile du Ryzen (43,0 en Vulkan) et devant l'autre (36,3 en ROCm). Le résultat est donc simple : sur un long document, la machine d'AMD écrit aussi vite avec sa meilleure pile (43,0 en Vulkan), mais elle met 2,8 à 6 fois plus de temps à le lire.
Dans l'usage, avec llama-server (le serveur de llama.cpp), notre ATOM lit un document de 30 000 tokens en 21,8 secondes avec gpt-oss 120B, puis écrit sa réponse à 42,8 tokens par seconde (mesure de notre premier guide de la série).
#Et avec plusieurs utilisateurs ?
Quand plusieurs personnes, ou plusieurs agents (des programmes d'IA qui travaillent seuls), interrogent la machine en même temps, un serveur comme vLLM regroupe leurs demandes et ne lit les poids du modèle qu'une seule fois pour l'ensemble des demandes. La bande passante cesse alors d'être le seul frein : la puissance de calcul du GB10 prend le relais.
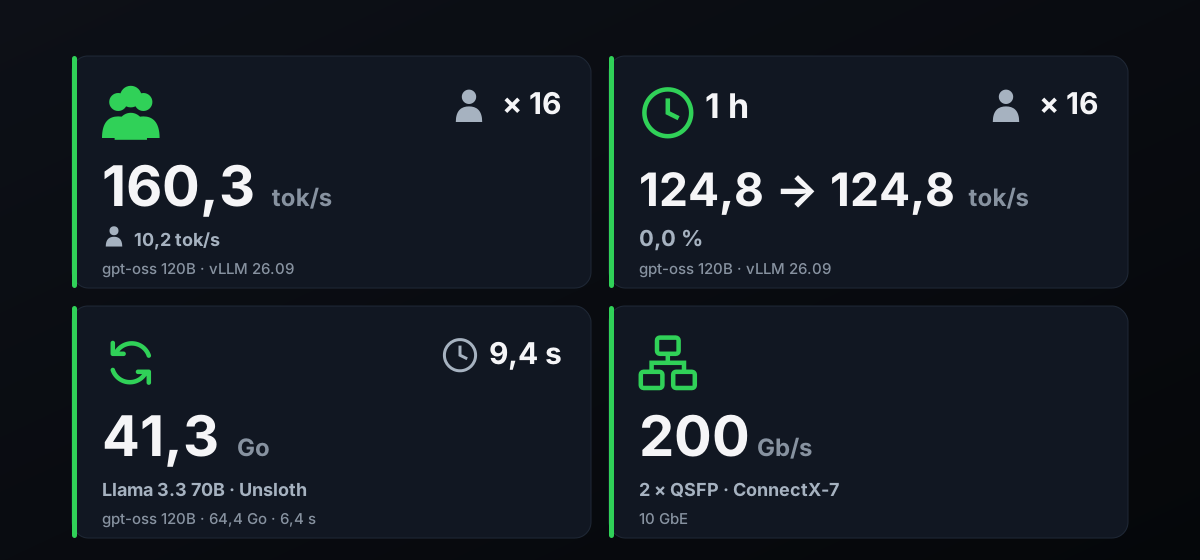
Dans notre premier guide, gpt-oss 120B passe de 35,6 tok/s pour une personne à 160,3 tok/s au total pour 16 personnes, chacune recevant encore 10,2 tok/s. gpt-oss 20B passe de 49,1 à 322,4 tok/s au total, avec 20,7 tok/s par personne (vLLM 26.09, 6 octobre 2026).
La tenue dans la durée compte autant que le pic. Pendant 1 h à 16 utilisateurs (demandes de 4 096 tokens, réponses de 512), gpt-oss 120B est resté à 124,8 tokens par seconde au total du début à la fin : de 122,6 à 128,1 selon les 14 tranches de mesure, soit 0,0 % de dérive, avec un GPU à 77 °C au plus et aucun bridage.
Pendant 2 h à 8 utilisateurs sur Llama 3.3 70B en NVFP4 (un format compressé de NVIDIA), le débit total est passé de 38,7 à 38,5 tokens par seconde (−0,6 %).
StorageReview a mesuré une charge du même type avec vLLM sur la machine AMD Ryzen AI Halo, de la famille Ryzen AI Max, face à un DGX Spark. La machine AMD est restée de 2 à 4 fois derrière dans la plupart des scénarios à forte concurrence, et jusqu'à 8,8 fois derrière sur un test à forte lecture avec gpt-oss 120B. Le DGX Spark partage la puce de l'ATOM ; ces chiffres Ryzen proviennent du test de StorageReview.
#Que change CUDA, pour l'entraînement en particulier ?
CUDA est la plateforme logicielle de NVIDIA pour calculer sur ses GPU. Sur l'ATOM, sous DGX OS 7.5.0 (CUDA 13.0, pilote 580.159.03), llama.cpp compilé pour la puce, vLLM dans le conteneur fourni par NVIDIA et Unsloth ont fonctionné chez nous. À notre connaissance, beaucoup d'outils d'IA sont d'abord écrits pour CUDA : c'est un atout pour servir des modèles et pour en entraîner.
Pour l'entraînement, NVIDIA annonce un réglage fin de modèles jusqu'à 70 milliards de paramètres sur la plateforme. Nous avons mesuré deux cas avec Unsloth 2026.10.1 et la méthode QLoRA (un réglage fin avec des poids compressés en 4 bits), séquences de 1 024 tokens, 40 étapes dont les 10 premières servent de chauffe.
Llama 3.3 70B demande 41,3 Go de mémoire GPU au pic et 9,4 secondes par étape. gpt-oss 120B demande 64,4 Go et 6,4 secondes par étape. Deux modèles de cette taille s'entraînent donc dans la mémoire de l'ATOM, avec de la marge.
Un cas concret : un réglage fin léger de type LoRA, de 85 minutes, sur Qwen3-8B (une époque, 2 000 exemples) a fait passer la part de factures extraites sans aucune erreur de 26,0 % à 95,0 %, sur 200 documents jamais vus et avec une notation stricte. C'est mieux que gpt-oss 120B sans entraînement (62,5 %). Les factures sont fictives, générées par nos soins. Notre guide de la série consacré au fine-tuning détaille la méthode.
Deux ports QSFP (la carte réseau ConnectX-7, 200 Gb/s selon GIGABYTE) et un port 10 GbE complètent la machine. Selon GIGABYTE, jusqu'à quatre machines GB10 peuvent être reliées en grappe ; nous n'avons pas testé ce montage.
#Combien coûtent ces trois machines ?
Prix TTC relevés le 8 octobre 2026 en France, sur les pages des marchands. Les prix GB10 bougent chaque semaine : vérifiez-les avant d'acheter.
| Machine | Configuration | Prix TTC | Marchand |
|---|---|---|---|
| GMKtec EVO-X2 (Ryzen AI Max+ 395) | 128 Go, SSD 2 To | 3 449,99 € | gmktec.fr |
| Minisforum MS-S1 MAX (Ryzen AI Max+ 395) | 128 Go, SSD 2 To | 4 159,00 € | minisforumpc.fr |
| AI TOP ATOM ATAGB10-9001 | 128 Go, SSD 4 To PCIe 4.0 | 6 346,27 € (épuisée le 8 octobre) | boutique officielle AORUS (en stock sur Amazon.fr) |
| MSI EdgeXpert (GB10) | 128 Go, SSD 4 To | 6 599,95 € (en rupture le 8 octobre) | Materiel.net |
| AI TOP ATOM ATAGB10-9000 | 128 Go, SSD 4 To PCIe 5.0 | 7 999,95 € (en rupture le 8 octobre) | LDLC, Materiel.net |
| Mac Studio M5 Max (18 cœurs CPU, 40 cœurs GPU) | 128 Go, SSD 512 Go | 5 859 € | apple.com/fr |
| Mac Studio M5 Max (18 cœurs CPU, 40 cœurs GPU) | 128 Go, SSD 4 To | 7 839 € (calcul) | apple.com/fr, options de stockage |
Le Ryzen AI Max+ 395 est la machine la moins chère. À stockage égal de 4 To, l'ATOM 9000 (SSD en PCIe 5.0, la version que nous avons mesurée) et un Mac Studio M5 Max sont dans la même fourchette. L'ATOM 9001, avec un SSD en PCIe 4.0, est la machine GB10 de 128 Go la moins chère du tableau ; à notre connaissance, elle garde la même puce et la même mémoire.
Le SSD joue surtout sur le temps de chargement d'un modèle, pas sur sa vitesse de calcul ; les relevés de SSD portent sur la version 9000. Nous donnons aussi le prix d'un Mac Studio M5 Max, car il utilise la même puce que les machines mesurées dans les publications ; sa vitesse n'a pas été mesurée dans ce guide.
Les deux ATOM se distinguent par leur châssis d'un litre (1,2 kg) et par les choix de GIGABYTE : refroidissement, finition, références.
#Ce que ce comparatif ne dit pas
- Origine des mesures
- Les chiffres du Ryzen AI Max+ 395 (un Framework Desktop de 128 Go) et du Mac M5 Max viennent de publications, avec leur build et leur date ; les mini-PC du tableau des prix n'ont pas été mesurés. Lisez les écarts de moins de 10 % comme une égalité : les builds changent, et deux unités d'un même modèle diffèrent de quelques pour cent.
- Le moteur MLX d'Apple n'est pas mesuré
- Sur Mac, MLX peut donner d'autres vitesses que llama.cpp ou Ollama. Notre guide MLX contre llama.cpp détaille cette différence.
- Un seul modèle commun avec le Mac
- Le format llama-bench publié pour le M5 Max ne couvre que llama 7B. Pour les grands modèles, nous n'avons que la mesure Ollama d'un lecteur.
- La qualité des réponses
- Ce guide compare des vitesses, pas la qualité des modèles.
- Plusieurs utilisateurs et entraînement sur les autres machines
- Nous ne les avons mesurés ni sur Ryzen ni sur Mac. Pour le Ryzen, nous citons StorageReview.
Mises à jour et corrections : cette page sera révisée si un nouveau build de llama.cpp ou une nouvelle publication change ces résultats ; chaque correction sera datée.
#Pour qui l'ATOM est le bon choix
Ce qui suit vient de nos mesures sur l'ATOM et des chiffres publiés cités plus haut.
- L'ATOM est le bon choix si vous lisez de longs documents ou du code
- Elle lit gpt-oss 120B 2,8 fois plus vite que le Ryzen AI Max+ 395 avec 32 768 tokens en mémoire, et un document de 30 000 tokens en 21,8 secondes.
- … si plusieurs personnes ou agents partagent la machine
- 160,3 tokens par seconde au total pour 16 utilisateurs avec gpt-oss 120B ; avec des demandes plus longues, le débit est resté à 124,8 tokens par seconde pendant 1 heure, sans baisse.
- … si vous entraînez ou adaptez des modèles
- Un QLoRA sur 70 milliards de paramètres tient dans 41,3 Go. Un LoRA sur des factures a pris 85 minutes.
- … si vous voulez de grands modèles MoE dans un boîtier d'un litre
- gpt-oss 120B écrit 58,8 tokens par seconde sur une machine de 1,2 kg.
- Un Mac M5 Max est plus adapté si vous écrivez seul avec de petits modèles denses
- Il écrit environ deux fois plus vite sur llama 7B (119,9 contre 59,4 tokens par seconde).
- Un mini-PC Ryzen AI Max+ 395 est plus adapté si le budget décide
- L'écriture reste proche sur les modèles MoE, à partir de 3 449,99 €, mais la lecture est de 2,1 à 2,8 fois plus lente.
En résumé : si votre travail consiste à lire de longs textes, l'ATOM est le bon choix d'après nos comparaisons. Pour servir plusieurs personnes ou entraîner, ses propres mesures sont solides : 160,3 tokens par seconde au total pour 16 utilisateurs, un QLoRA de 70 milliards de paramètres dans 41,3 Go. Si vous écrivez seul avec de petits modèles denses, regardez le Mac. Si le budget décide, regardez le Ryzen.
#FAQ
Quelle machine est la plus rapide entre le GB10, le Ryzen AI Max+ 395 et le Mac M5 Max ?+
L'AI TOP ATOM est-elle plus rapide qu'un Mac M5 Max ?+
Pourquoi les chiffres d'une même machine changent-ils d'un site à l'autre ?+
Comment comparer ma propre machine à ces chiffres ?+
Le Ryzen AI Max+ 395 est-il un bon choix face au GB10 ?+
Un retour, une erreur, une précision ? Faites-nous signe, ça améliore le guide pour tout le monde.