Fine-tuning en local sur GB10 : mesures et méthode
Sur une GIGABYTE AI TOP ATOM (puce NVIDIA GB10, 128 Go), un petit modèle entraîné pour une tâche précise peut dépasser un très grand modèle sur cette tâche. En 85 minutes de LoRA, Qwen3-8B extrait sans aucune erreur les données de 95 % de 200 factures fictives jamais vues, contre 62,5 % pour gpt-oss 120B et 26 % sans entraînement. Le QLoRA avec Unsloth tient aussi : 41 Go pour un 70B, 64 Go pour gpt-oss 120B. L'entraînement a coûté 1,5 centime d'électricité côté GPU.
Le fine-tuning entraîne un peu plus un modèle existant pour qu'il réussisse une tâche précise. Avec 128 Go de mémoire unifiée, une machine GB10 le fait chez vous, sans louer de serveur ni confier vos données à un service en ligne. Ce guide suit un cas complet, mesuré sur une AI TOP ATOM fournie gracieusement par GIGABYTE : extraire en JSON les données de factures. Il donne aussi les mesures du QLoRA (la même méthode sur un modèle compressé en 4 bits) avec Unsloth jusqu'à gpt-oss 120B, et les commandes de nos essais.
#Le cas réel : lire des factures et produire du JSON
La tâche est courante dans une petite entreprise : à partir du texte d'une facture, d'un devis ou d'un avoir, le modèle doit renvoyer un JSON, c'est-à-dire une fiche structurée qu'un logiciel sait lire. Cette fiche compte 31 champs notés : type de document, numéro, dates, émetteur, client, lignes de produits, remise, totaux, TVA, acompte, IBAN. Nous avons choisi cette tâche parce que la réponse se vérifie champ par champ, sans qu'un autre modèle ait à juger.
Les documents sont fictifs. Un petit programme a généré 12 mises en page, c'est-à-dire 12 formes de facture, avec des noms d'entreprises inventés. Son hasard est réglé par une « graine » fixe : il redonne les mêmes documents à chaque exécution. L'entraînement utilise 2 000 documents sur 10 mises en page.
L'évaluation utilise 200 documents jamais vus : 100 sur les 10 mêmes mises en page, et 100 sur 2 mises en page absentes de l'entraînement. Ces 100 derniers disent si le modèle a compris la tâche ou s'il a seulement retenu des formes.
Le modèle reçoit le texte du document, pas une image ni un PDF. Voici un extrait de la réponse du modèle entraîné sur le premier document de test, un avoir fictif de quatre lignes.
#La méthode : LoRA, une époque, 85 minutes
Ton ChatGPT privé et gratuit sur ta machine en 1 heure — LM Studio, Ollama, Open WebUI, tes documents, sans cloud.
- Espace en ligne à vie
- PDF + fichiers
- Remboursé 30 j
La machine est une GIGABYTE AI TOP ATOM, référence ATAGB10-9000 : puce NVIDIA GB10, 128 Go de mémoire unifiée, SSD de 4 To en PCIe 5.0, sous DGX OS 7.5.0 (pilote 580.159.03, CUDA 13.0). Les logiciels : le conteneur PyTorch de NVIDIA (version 26.03, avec PyTorch 2.11), PEFT 0.21.2 pour le LoRA, Unsloth 2026.10.1 pour le QLoRA et, pour le service, le conteneur vLLM 26.09 de NVIDIA (vLLM 0.29.0). Notre premier guide de la série détaille la machine et la vitesse de 13 modèles.
LoRA (Low-Rank Adaptation) laisse le modèle d'origine intact et entraîne de petites matrices ajoutées à ses couches. Le résultat est un adaptateur, un petit fichier que l'on charge avec le modèle. Ici, 43,6 millions de paramètres sont entraînés, contre 8 milliards pour Qwen3-8B.
Trois mots reviennent dans ce guide. Un pas d'entraînement traite un lot de 4 documents. Une époque est un passage complet sur les 2 000 documents. La perte mesure l'écart entre la réponse écrite par le modèle et la réponse attendue : plus elle est basse, mieux c'est.
- Modèle
- Qwen3-8B en bf16, un format de nombres à 16 bits, sans compression.
- LoRA
- Rang 16, alpha 32 (un coefficient d'échelle), dropout 0,05 (une petite part des valeurs est ignorée au hasard à chaque pas, pour limiter le sur-apprentissage), sur les 7 projections de chaque couche, c'est-à-dire ses 7 matrices de poids : q, k, v, o, gate, up, down. Le rang fixe la taille des matrices ajoutées.
- Durée
- 1 époque : 500 pas de 4 documents.
- Taux d'apprentissage
- 1e-4, soit 0,0001, avec une montée progressive sur 30 pas puis une décroissance en cosinus.
- Lots
- Nous trions les 2 000 documents par longueur, nous formons les lots, puis nous mélangeons leur ordre avec une graine fixe. Un lot contient des documents de longueur voisine : il y a moins de remplissage inutile, donc l'entraînement va plus vite.
- Perte
- Calculée sur la réponse JSON seule. La consigne et le document sont masqués : le modèle apprend à écrire la réponse, pas à recopier le document.
- Longueur
- Jusqu'à 2 304 tokens. Le document le plus long en compte 2 204, la moyenne est de 1 143 : aucun n'est coupé.
- Mémoire
- Le gradient checkpointing est actif : le modèle recalcule certains résultats au lieu de tous les garder en mémoire.
Ces réglages ont été fixés par un avenant à notre protocole, daté du 7 octobre 2026, avant toute évaluation sur les 200 documents de test. Le protocole a été figé avant la première mesure ; la méthode, la liste datée des avenants et les données de nos tableaux sont publiées sur notre page de méthode. Les mémoires de ce guide sont en Go, comme les affiche Linux : 1 Go = 1 024 Mo.
Tout se passe dans le conteneur PyTorch de NVIDIA (version 26.03). Un environnement Python y reçoit les bibliothèques transformers et PEFT. Les chemins ci-dessous sont simplifiés ; les options sont celles de nos essais.
#Les résultats : 95 % de documents parfaits
La note compare, champ par champ, la valeur écrite par le modèle à la valeur attendue, après normalisation. Un document est « parfait » quand tous ses champs sont exacts. Les trois modèles reçoivent la même consigne, à la température 0 (le réglage qui rend les réponses les plus stables), par vLLM 26.09, 16 documents à la fois. Pour Qwen3-8B, la réflexion est désactivée. Pour gpt-oss 120B, l'effort de raisonnement est réglé sur « faible ».
| Modèle | Champs exacts | Documents parfaits | Parfaits, mises en page connues | Parfaits, mises en page nouvelles | Durée pour 200 documents |
|---|---|---|---|---|---|
| Qwen3-8B sans entraînement | 84,8 % | 26,0 % | 27 % | 25 % | 686 s |
| gpt-oss 120B sans entraînement | 97,5 % | 62,5 % | 58 % | 67 % | 991 s |
| Qwen3-8B + LoRA (85 min) | 99,2 % | 95,0 % | 96 % | 94 % | 524 s |
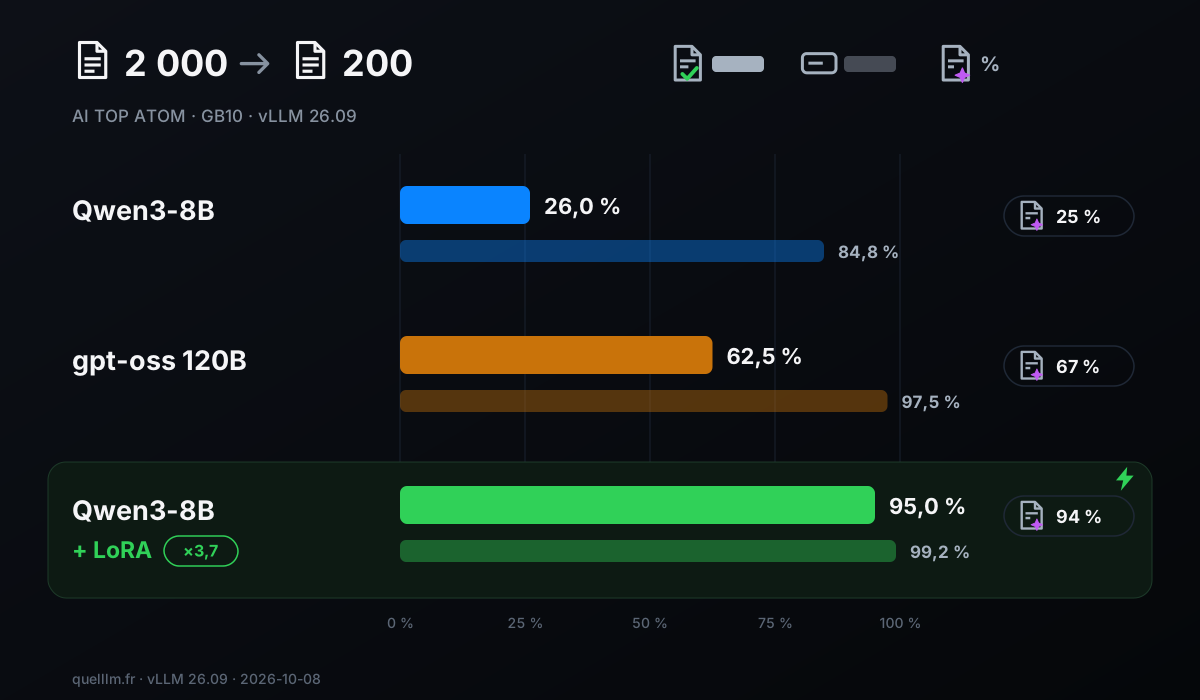
Le modèle entraîné obtient 95,0 % de documents parfaits, contre 26,0 % pour le même modèle sans entraînement : 69 points de plus, soit 3,7 fois plus de documents sans erreur. Il dépasse gpt-oss 120B (62,5 %), un modèle de 117 milliards de paramètres. C'est aussi le plus rapide : 524 secondes pour les 200 documents, contre 991 secondes pour gpt-oss 120B et 686 secondes pour Qwen3-8B sans entraînement. Ses réponses sont aussi plus courtes : 98 847 tokens écrits, contre 160 702 pour gpt-oss 120B.
Sur les 100 documents de mises en page jamais vues, le modèle entraîné garde 94 % de documents parfaits et 98,5 % de champs exacts, contre 96 % et 99,9 % sur les mises en page connues. L'écart est de 2 points sur les documents parfaits (96 % contre 94 %) : l'adaptateur ne se limite pas aux formes vues pendant l'entraînement.
Le détail par champ montre ce que l'entraînement a corrigé. Les 31 champs sont tous exacts dans au moins 97,5 % des documents, et 18 d'entre eux dans 100 % des documents. Sans entraînement, 10 champs sont exacts entre 49,5 % et 61,5 % du temps : les montants (remise, totaux, TVA, acompte, net à payer) et les lignes (quantité, prix unitaire, taux de TVA, montant). Après entraînement, ces 10 champs sont exacts de 98 % à 100 %.
Les trois modèles renvoient un JSON valide dans 100 % des cas et trouvent le bon nombre de lignes dans 100 % des documents. La différence se joue donc sur la valeur des champs, pas sur la forme de la réponse.
#Ce que cela coûte : temps, mémoire, électricité
| Mesure | Valeur |
|---|---|
| Durée de l'entraînement | 5 090 s, soit 85 min (10,2 s par pas) |
| Pic de mémoire GPU relevé par PyTorch | 33,3 Go |
| Puissance du GPU, moyenne et pointe | 53,0 W et 62,7 W |
| Température du GPU, moyenne et maximum | 65 °C et 77 °C |
| Bridage signalé par le GPU | aucun sur les 5 206 relevés |
| Énergie du GPU pour l'entraînement (87 minutes de relevé, chargement compris) | 76,7 Wh |
| Coût au tarif EDF Tarif Bleu Base (20,01 centimes par kWh TTC) | 1,5 centime |
| Énergie du GPU pour lire les 200 documents de test avec le modèle entraîné | environ 6 Wh |
Ces chiffres concernent le GPU seul, tel que la puce le rapporte. Selon NVIDIA, la puissance affichée par nvidia-smi est celle du GPU seul. Le processeur, la mémoire, le SSD et l'alimentation ne sont pas comptés. Le tarif est celui de l'option Base d'EDF pour 6 kVA, dans la grille applicable au 1er août 2026 ; l'abonnement n'est pas compté.
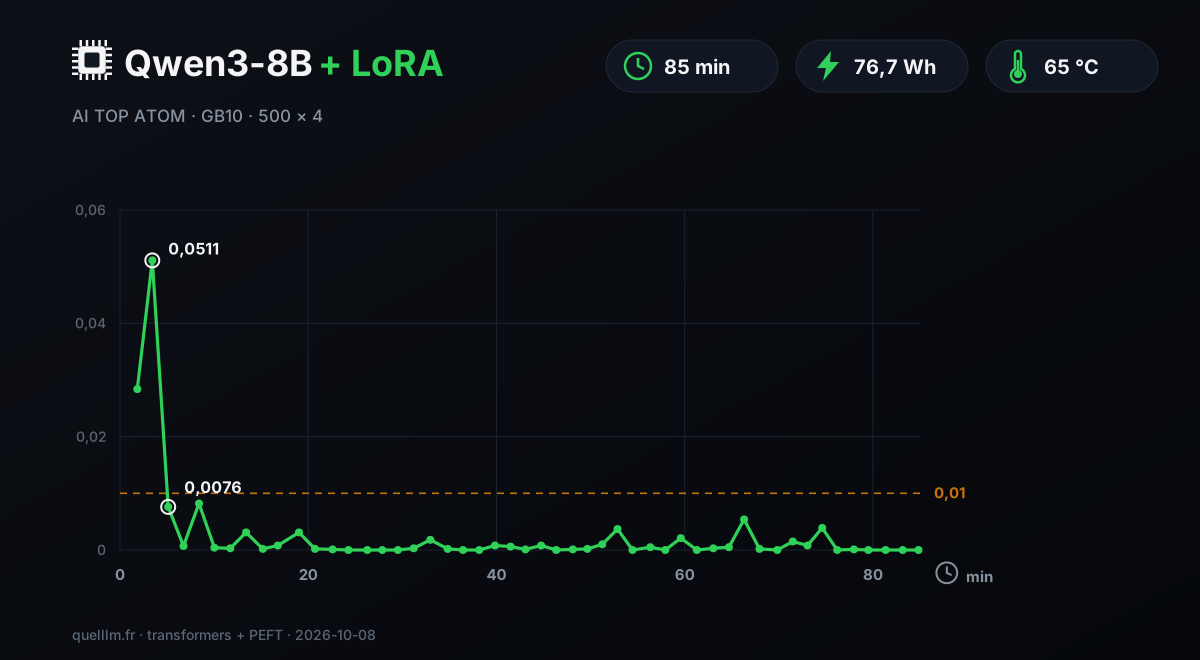
Chaque point de la courbe vient d'un seul lot de 4 documents : les valeurs varient donc d'un relevé à l'autre. La perte passe sous 0,01 dès le pas 30, après 5 minutes d'entraînement, et aucun relevé suivant ne dépasse 0,0082. Une seule époque a suffi pour atteindre 95 % de documents parfaits sur ce cas.
#QLoRA avec Unsloth : un 70B et gpt-oss 120B sur la même machine
Le QLoRA compresse les poids du modèle à 4 bits, ce qui réduit fortement sa place en mémoire, puis entraîne un adaptateur LoRA par-dessus. C'est la voie pour spécialiser un gros modèle sans changer de machine. Nous avons utilisé Unsloth, un outil libre qui, selon son éditeur, allège et accélère le fine-tuning.
NVIDIA publie un guide officiel pour Unsloth sur DGX Spark, dans un conteneur PyTorch de NVIDIA (version 25.11), et propose aussi un environnement officiel de fine-tuning PyTorch pour des modèles de 1 à 70 milliards de paramètres. Unsloth annonce environ 68 Go de mémoire pour un QLoRA 4 bits de gpt-oss 120B ; notre mesure est de 64,4 Go de pic, du même ordre.
Nous avons mesuré la vitesse et la mémoire sur deux modèles : Llama 3.3 70B et gpt-oss 120B, tous deux au format 4 bits publié par Unsloth. Chaque essai compte 40 étapes, et les 10 premières, qui servent à la mise en route, ne sont pas comptées dans la moyenne.
Les séquences font 1 024 tokens, avec un lot de 1 et un LoRA de rang 16. Ces étapes, faites sur le texte de référence de notre protocole, mesurent le débit et la mémoire ; elles ne produisent pas un modèle utile.
| Modèle | Chargement | Mémoire du modèle | Pic de mémoire GPU | Secondes par étape | Tokens par seconde | Paramètres entraînés |
|---|---|---|---|---|---|---|
| Llama 3.3 70B (QLoRA 4 bits) | 247 s | 37,6 Go | 41,3 Go | 9,39 | 109 | 207 millions (7 projections) |
| gpt-oss 120B (QLoRA 4 bits) | 397 s | 58,5 Go | 64,4 Go | 6,35 | 161 | 11,9 millions (4 projections d'attention) |
| Qwen3-8B (LoRA bf16) | — | — | 63,4 Go | 5,42 | 756 | 43,6 millions (7 projections) |
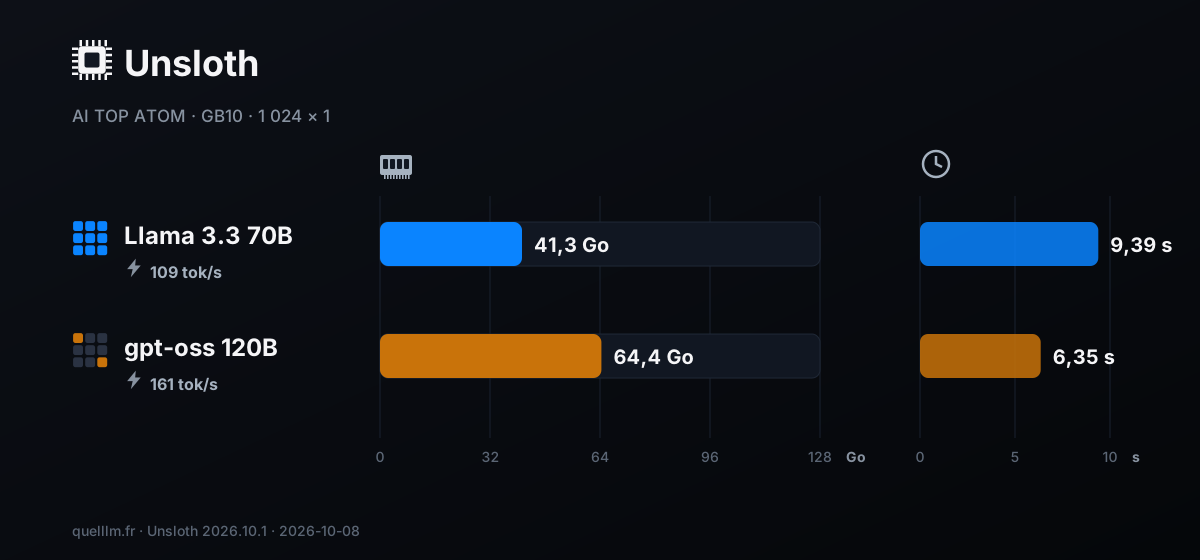
Le 70B s'entraîne avec 41,3 Go de pic, environ un tiers des 121,7 Go que voit le système ; gpt-oss 120B en demande 64,4 Go. Dans les deux cas, il reste de la place pour d'autres services. Fait notable : gpt-oss 120B avance plus vite par étape que le 70B (6,35 s contre 9,39 s), bien qu'il soit plus gros.
C'est un modèle MoE, un « mélange d'experts » : à chaque token, il n'utilise que 5,1 de ses 117 milliards de paramètres. Nous n'y entraînons que les 4 matrices de l'attention (q, k, v, o), soit 11,9 millions de paramètres. Le 70B reçoit un LoRA sur ses 7 projections, soit 207 millions de paramètres entraînés.
Pour planifier, voici un calcul à partir de nos mesures. 1 000 étapes de 1 024 tokens, soit environ un million de tokens, prendraient 2 h 36 min avec le 70B et 1 h 46 min avec gpt-oss 120B. Vérifiez ces durées sur votre jeu de données. Le QLoRA du 70B a occupé le GPU 10,8 minutes, chargement du modèle compris, pour 8,9 Wh côté GPU.
Unsloth 2026.10.1 est installé dans le même environnement Python que ci-dessus, dans le même conteneur PyTorch. Pour l'installation pas à pas, suivez le guide officiel de NVIDIA et la documentation d'Unsloth, liés en fin de page.
#Servir le modèle entraîné avec vLLM
vLLM est un serveur libre, conçu pour répondre à plusieurs personnes à la fois ; nous l'utilisons dans le conteneur fourni par NVIDIA. Il charge le modèle d'origine puis y ajoute l'adaptateur. L'API expose alors deux noms : Qwen3-8B, sans adaptateur, et factures, avec l'adaptateur. Nous avons évalué les deux sur le même serveur, ce qui rend la comparaison équitable.
Avec 16 documents envoyés à la fois, les 200 factures passent en 524 secondes. À ce rythme, 1 000 factures prennent environ 44 minutes : c'est un calcul à partir de notre mesure. Le port est lié à l'adresse locale 127.0.0.1. Pour ouvrir le service à votre réseau, ajoutez une clé d'API ; le guide sur vLLM en production détaille cette étape.
#Refaire ce cas chez vous en cinq étapes
- 01Préparez les exemplesRassemblez des paires : le texte d'un document et la réponse JSON attendue. Écrivez une seule consigne, la même pour l'entraînement et pour l'évaluation. Nous avons utilisé 2 000 exemples ; nous n'avons pas mesuré de seuil minimal.
- 02Gardez un jeu de testMettez des documents de côté sans jamais les montrer au modèle. Ajoutez-y quelques mises en page absentes de l'entraînement, pour savoir si le modèle généralise.
- 03Entraînez une époqueTriez les exemples par longueur, formez les lots, calculez la perte sur la réponse seule et surveillez la courbe de perte.
- 04Notez avant et aprèsNotez le modèle d'origine et le modèle entraîné avec la même consigne, champ par champ. Notez aussi un grand modèle sans entraînement : c'est la comparaison la plus utile.
- 05Servez avec vLLMChargez l'adaptateur avec l'option enable-lora et branchez votre logiciel sur l'API.
#Fine-tuning, RAG ou meilleure consigne : que choisir ?
Commencez par la consigne : c'est gratuit et immédiat. Si le modèle doit retrouver des faits dans vos documents, un RAG convient mieux : c'est un assistant qui cherche d'abord dans vos fichiers, avant de répondre.
Le fine-tuning est le bon outil quand la tâche se répète, que le format de sortie doit rester stable et que vous avez des exemples. La lecture de factures répond à ces trois conditions. Les deux approches se combinent sur la même machine ; un autre guide de la série montre un assistant RAG complet.
#Les limites de nos mesures
- Documents fictifs
- Nos factures sont produites par un script, avec 12 mises en page. Des documents réels, scannés ou photographiés, demandent d'abord une lecture du texte (OCR) et peuvent donner d'autres résultats.
- Un seul entraînement
- Nous avons entraîné un seul adaptateur et noté chaque modèle une fois, à la température 0. Nous n'avons pas mesuré la variation d'un entraînement à l'autre ni comparé avec un entraînement plus long.
- gpt-oss 120B
- Il est noté avec un effort de raisonnement faible. Un autre réglage peut changer son score.
- QLoRA
- Les mesures QLoRA portent sur la vitesse et la mémoire, sur 40 étapes. Nous n'avons pas évalué la qualité de modèles 70B ou 120B entraînés.
- Énergie
- Elle concerne le GPU seul.
- Hors périmètre
- Nous n'avons pas mesuré l'entraînement de tous les paramètres d'un modèle, ni l'usage de plusieurs machines reliées.
Mises à jour et corrections : cette page sera révisée si une nouvelle version d'Unsloth, de vLLM ou de DGX OS change ces résultats ; chaque correction sera datée.
#Pour qui l'ATOM est le bon choix
- Une PME ou un cabinet qui veut spécialiser un petit modèle sur ses documents
- 85 minutes et 1,5 centime d'électricité côté GPU pour passer de 26 % à 95 % de factures parfaites sur notre jeu de factures fictives, sans envoyer un seul document à un tiers.
- Un développeur ou une équipe de données qui construit des prototypes
- Qwen3-8B en LoRA, un 70B ou gpt-oss 120B en QLoRA : les trois tiennent sur la même machine, avec 33 à 64 Go de pic de mémoire GPU.
- Une équipe qui veut entraîner, évaluer et servir au même endroit
- La même machine a entraîné l'adaptateur, noté trois modèles et servi les réponses avec vLLM.
- Un bureau sans salle serveur
- Un boîtier d'un litre (150 × 150 × 50,5 mm, 1,2 kg) alimenté par un adaptateur USB-C de 240 W.
Séparons la plateforme et le constructeur. La puce NVIDIA GB10, ses 128 Go de mémoire unifiée à 273 Go/s, CUDA et DGX OS 7.5.0 déterminent l'essentiel des vitesses d'entraînement. En inférence, nos mesures sont à 4,3 % près au plus de celles publiées pour le DGX Spark ; les entraînements de ce guide ont été réalisés sur l'AI TOP ATOM.
GIGABYTE apporte le châssis et son refroidissement à deux ventilateurs. Pendant les 87 minutes de relevé de l'entraînement, à 53 W en moyenne côté GPU, la température est restée à 65 °C en moyenne et 77 °C au plus, sans aucun bridage signalé.
Prix relevés le 8 octobre 2026 pour l'ATAGB10-9001 (128 Go, SSD de 4 To en PCIe 4.0) : 6 346,27 € TTC à la boutique officielle AORUS, où elle était épuisée ; elle était en stock sur Amazon.fr. Nous avons mesuré la référence ATAGB10-9000, dont le SSD est en PCIe 5.0. Les prix GB10 bougent chaque semaine : vérifiez-les avant d'acheter.
#FAQ
Combien de temps faut-il pour fine-tuner un modèle de 8 milliards de paramètres sur une GB10 ?+
Peut-on fine-tuner un modèle 70B ou gpt-oss 120B sur 128 Go ?+
Un petit modèle entraîné peut-il vraiment dépasser un grand modèle ?+
Combien coûte l'électricité d'un fine-tuning ?+
Comment utiliser l'adaptateur une fois l'entraînement terminé ?+
Faut-il la version 128 Go de l'ATOM pour fine-tuner ?+
Un retour, une erreur, une précision ? Faites-nous signe, ça améliore le guide pour tout le monde.