LLM 70B en local sur GB10 : le tutoriel complet
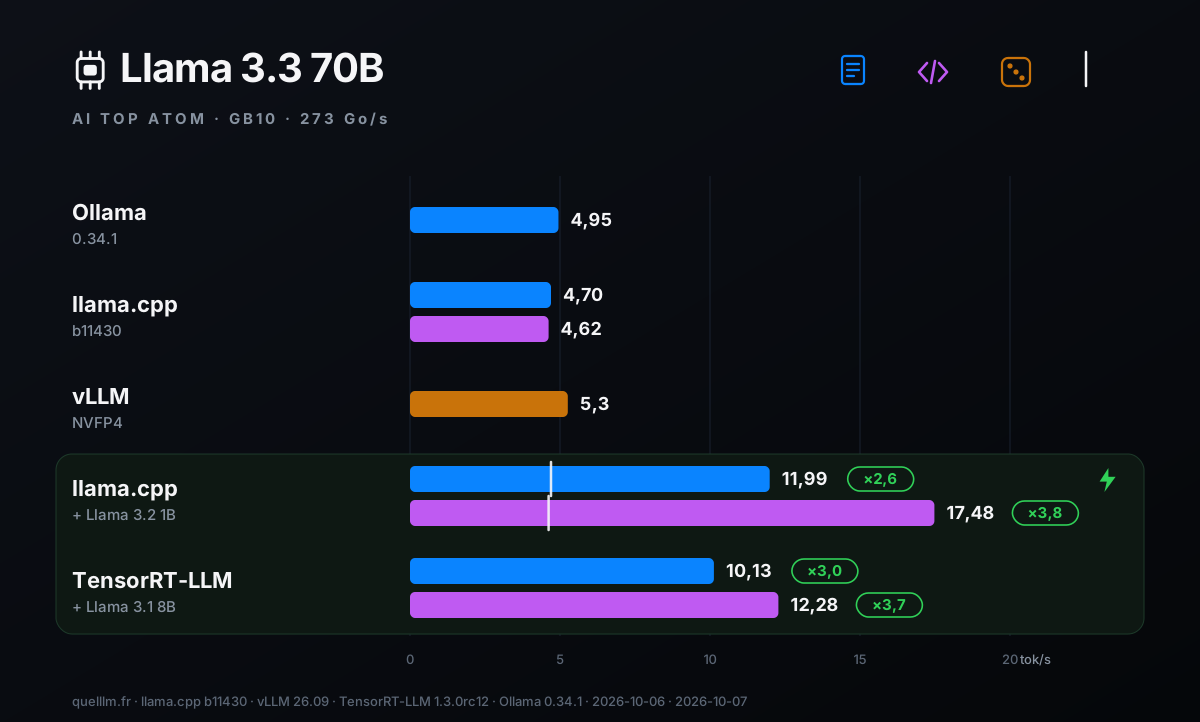
Sur une GIGABYTE AI TOP ATOM (puce NVIDIA GB10, 128 Go), Llama 3.3 70B tient avec de la marge : 43,6 Go avec un contexte de 8 192 tokens, 82 Go avec 131 072. Il écrit entre 4,6 et 5,3 tokens par seconde avec trois voies : Ollama, llama.cpp ou vLLM. Un brouillon Llama 3.2 1B porte llama.cpp à 12 tokens par seconde en prose et 19 en code. À huit utilisateurs, vLLM tient 38,6 tokens par seconde au total en moyenne pendant deux heures.
Un modèle de 70 milliards de paramètres comme Llama 3.3 70B est « dense » : il utilise tous ses paramètres pour écrire chaque mot, et il lui faut beaucoup de mémoire. Les 128 Go d'une machine GB10 l'accueillent largement. Ce tutoriel donne les commandes de trois façons de l'installer, testées sur une AI TOP ATOM fournie gracieusement par GIGABYTE, puis les mesures qui aident à choisir : vitesse, petit modèle brouillon, mémoire du contexte, tenue sur deux heures et service à plusieurs.

#La machine, la méthode et les unités
Quelques mots de vocabulaire d'abord. Un token est un morceau de mot : en français, un token vaut environ deux tiers de mot. Le contexte est le texte que le modèle garde en mémoire pendant un échange : vos questions, vos documents et ses réponses. La vitesse d'écriture est le rythme d'affichage de la réponse, en tokens par seconde (tok/s). La vitesse de lecture est le rythme auquel la machine absorbe votre texte avant de répondre.
La machine est une GIGABYTE AI TOP ATOM, référence ATAGB10-9000. Sa puce NVIDIA GB10 réunit 20 cœurs Arm et un GPU Blackwell, qui se partagent 128 Go de mémoire à 273 Go/s. Le SSD fait 4 To en PCIe 5.0. Elle tourne sous DGX OS 7.5.0, le système de NVIDIA basé sur Ubuntu (pilote 580.159.03, CUDA 13.0). Le système voit 121,7 Go de mémoire.
- Ce qui vient de la plateforme NVIDIA GB10
- La puce, ses 128 Go à 273 Go/s et DGX OS fixent les vitesses de ce guide. En rejouant deux références publiées pour le DGX Spark de NVIDIA, avec llama.cpp et avec Ollama, nos vitesses sont à 4,3 % près au plus. À notre connaissance, elles devraient donc valoir pour les autres machines GB10 de 128 Go. Les relevés de ce guide portent sur l'AI TOP ATOM.
- Ce qui vient de GIGABYTE
- Le châssis d'environ un litre et son refroidissement, la finition, les références (la 9000 porte un SSD de 4 To en PCIe 5.0) et la garantie du revendeur. Pendant nos deux heures de service continu, le GPU n'a pas dépassé 72 °C et aucun bridage n'est apparu.
Les mesures datent des 6 et 7 octobre 2026 (l'assistant privé avec Open WebUI, des 7 et 8 octobre). Le protocole a été figé le 6 octobre à 13 h 30, avant la première mesure. Des avenants datés, écrits avant les essais qu'ils décrivent, ont ajouté le décodage spéculatif et le budget mémoire. La méthode et les données de nos tableaux sont publiées sur notre page de méthode.
Les vitesses d'écriture de llama.cpp et de TensorRT-LLM viennent de six textes de 400 tokens : trois en prose française et trois demandes de code. Celles d'Ollama (un texte de 300 mots) et de vLLM (requêtes aléatoires de 1 024 tokens en entrée et 256 en sortie) suivent les protocoles décrits dans leurs sections. La température est fixée à 0 : le modèle choisit toujours le mot le plus probable, ce qui rend les essais comparables. Nous publions la médiane des trois textes de chaque type.
Les tailles de mémoire sont en Go (1 Go = 1 024 Mo, comme l'affiche Linux) ; les débits en Go/s sont ceux annoncés par les fabricants, en unités décimales. Les versions utilisées sont llama.cpp b11430 (build du 5 octobre 2026), Ollama 0.34.1, vLLM 26.09 et TensorRT-LLM 1.3.0rc12, ces deux derniers dans les conteneurs de NVIDIA. Notre premier guide de la série donne les mesures de 13 modèles, dont Llama 3.3 70B ; celui-ci montre comment l'installer et l'accélérer.
#Voie 1 : Ollama, la plus simple
Ollama est la façon la plus simple de démarrer : une archive à décompresser, une commande pour télécharger le modèle, une autre pour lui parler. Nous avons installé la version 0.34.1 à partir de l'archive officielle pour Linux Arm, dans un dossier et sans service système. Si vous préférez l'installateur habituel, notre guide d'installation sur Linux le décrit.
L'option --verbose fait afficher les statistiques à la fin de la réponse. Chez nous, Llama 3.3 70B (en Q4_K_M, une compression des poids) écrit à 4,97 tok/s au premier passage et à 4,95 tok/s au second. La commande ollama ps indique 85 Go chargés, en unités décimales : Ollama a ouvert de lui-même un contexte de 131 072 tokens. Sur un texte de 18 823 tokens, la lecture prend 55,6 s, soit 338,7 tok/s, et l'écriture qui suit reste à 4,38 tok/s.
Pour situer ces chiffres : Ollama publie 4,423 tok/s pour Llama 3.1 70B Q4_K_M sur un DGX Spark de NVIDIA (version 0.12.6, 23 octobre 2025). Avec la même version, le même script et le même modèle (Llama 3.1 70B), notre ATOM donne 4,34 tok/s, à 2 % près. Pour réduire le contexte et la mémoire occupée, définissez la variable OLLAMA_CONTEXT_LENGTH avant de lancer le serveur ; nous n'avons pas mesuré cette variante.
#Voie 2 : llama.cpp, celle qui offre le plus de réglages
llama.cpp est un moteur open source très répandu. Il lit les modèles au format GGUF, un fichier unique qui contient les poids. Il faut le compiler une fois pour la puce GB10, mais il donne accès à tous les réglages : taille du contexte, format du cache du contexte, modèle brouillon. La compilation reprend le guide de NVIDIA, avec l'architecture CUDA 121a-real, celle de la GB10, mais sans libcurl (-DLLAMA_CURL=OFF) ni RPC.
Le fichier choisi est Llama 3.3 70B en Q4_K_M, publié par bartowski : 39,6 Go. Avec le cache du disque vidé, llama.cpp le charge en 8 s depuis le SSD. La commande hf vient de la bibliothèque huggingface_hub (installation : pip install -U huggingface_hub). Si Hugging Face demande d'accepter la licence Llama, acceptez-la sur le site, puis connectez-vous avec hf auth login.
- -ngl 99
- Place toutes les couches du modèle sur le GPU.
- -fa on
- Active Flash Attention, qui rend la lecture du contexte plus économe.
- -lm dio
- Lit le fichier par accès direct au disque, sans passer par le cache du système (mmap). C'est le mode du tableau de référence publié par le projet llama.cpp pour le DGX Spark.
- -c 16384 -np 1
- Un contexte de 16 384 tokens pour un seul utilisateur. Le contexte demandé est partagé entre les utilisateurs simultanés.
- --host 127.0.0.1
- Le serveur n'est joignable que depuis la machine elle-même.
Sur nos six textes, llama-server écrit à 4,70 tok/s en prose et 4,62 en code. L'outil de mesure llama-bench donne 4,8 tok/s en écriture (32 tokens) et 405 tok/s en lecture (2 048 tokens). Le modèle occupe 43,6 Go avec un contexte de 8 192 tokens.
À titre de repère, la mémoire lit au plus 273 milliards d'octets par seconde, et chaque token demande de relire les poids du modèle, soit 42,5 milliards d'octets : le maximum théorique est de 6,4 tok/s, et la mesure en atteint environ les trois quarts.
#Voie 3 : vLLM en NVFP4, pour plusieurs utilisateurs
vLLM est un serveur conçu pour répondre à plusieurs personnes en même temps. NVIDIA le fournit dans un conteneur, c'est-à-dire un programme isolé que lance Docker. Le modèle est Llama 3.3 70B en NVFP4, un format 4 bits de NVIDIA que les puces Blackwell calculent directement : il occupe 39,9 Go en mémoire. La matrice des modèles pris en charge dans le guide vLLM de NVIDIA pour DGX Spark liste ce modèle.
Les réglages --max-model-len 8192 et --max-num-seqs 16 limitent le contexte à 8 192 tokens et à 16 requêtes traitées en même temps. Le réglage --gpu-memory-utilization 0.85 fixe la part de mémoire que vLLM réserve : ici 103 Go, dont 59,6 Go de cache. Ce cache garde en même temps 390 352 tokens, soit l'équivalent de près de 48 requêtes de 8 192 tokens à la fois. Le premier démarrage prend environ 7 minutes : 4 min 20 s pour lire le modèle, puis environ 2 minutes de préparation.
Pour un utilisateur, vLLM écrit à 5,3 tok/s (5,26, 5,27 et 5,26 sur trois séries) et le premier mot arrive en 0,73 s en moyenne. Avec huit utilisateurs simultanés, la machine écrit 37,7 tok/s au total, attente du premier mot comprise ; une fois sa réponse commencée, chaque utilisateur reçoit 5,0 tok/s.
Le premier mot arrive en 2,8 s en moyenne et en moins de 4,8 s dans les cas les plus lents. Les requêtes de ce test ont 1 024 tokens en entrée et 256 en sortie ; chaque point est mesuré trois fois.
#Les trois voies côte à côte
| Voie | Écriture | Mémoire | Réglages | À choisir pour |
|---|---|---|---|---|
| Ollama 0.34.1 (Q4_K_M) | 4,95 | 85 Go affichés par Ollama (en unités décimales, soit environ 79 Go au sens de ce guide) avec le contexte de 131 072 tokens qu'il ouvre sans réglage | peu | démarrer vite |
| llama.cpp b11430 (Q4_K_M) | 4,70 en prose, 4,62 en code | 43,6 Go à 8 192 tokens, 51,3 Go à 32 768 | tous : contexte, cache, brouillon | un utilisateur, avec un brouillon |
| vLLM 26.09 (NVFP4) | 5,3 ; 37,7 au total pour 8 utilisateurs | 103 Go réservés avec le réglage 0,85 | ceux d'un serveur | plusieurs utilisateurs |
Les trois voies écrivent à la même vitesse, à moins de 15 % près. La raison est simple : pour chaque token, la puce relit les poids du modèle, et c'est la bande passante de 273 Go/s qui fixe le rythme d'un modèle dense. Un 70B écrit donc à environ 5 tok/s, soit environ 200 mots par minute, le rythme d'une lecture posée.
Ce rythme convient aux traitements patients : résumés, extractions, relectures, brouillons de réponses. Pour une conversation vive, deux leviers existent, présentés dans les sections suivantes : le modèle brouillon, et un modèle MoE (mixture of experts) qui n'utilise qu'une partie de ses paramètres à chaque token.
#Accélérer un 70B avec un petit modèle brouillon
Le décodage spéculatif utilise un petit modèle, le brouillon, qui propose plusieurs mots d'avance (plus exactement des tokens ; nous disons « mots » pour simplifier). Le gros modèle vérifie ces mots en une seule passe : cela coûte à peu près le temps d'en écrire un seul, car le temps est surtout celui de la lecture des poids.
Les mots justes sont gardés, les autres sont écartés. Le brouillon ne choisit pas le texte : c'est toujours le gros modèle qui valide. NVIDIA décrit le principe dans son guide pour DGX Spark, et le blog LMSYS note que cette technique réduit en partie la limite de bande passante de la machine.
#Avec llama.cpp : un brouillon Llama 3.2 1B
Le brouillon doit parler la même langue que le gros modèle, c'est-à-dire utiliser le même découpage en tokens. La famille Llama convient : Llama 3.2 1B, en Q8_0, accompagne Llama 3.3 70B. Quatre options suffisent : -md désigne le brouillon, --spec-type draft-simple choisit la méthode, --spec-draft-n-max fixe le nombre de tokens proposés d'avance (nous les appelons « mots » dans ce guide) et -ngld 99 place le brouillon sur le GPU.
| Configuration | Prose française | Code | Acceptation (prose / code) |
|---|---|---|---|
| 70B seul | 4,70 | 4,62 | — |
| + brouillon Llama 3.2 1B, 8 mots d'avance | 11,99 (×2,6) | 17,48 (×3,8) | 33 % / 50 % |
| + brouillon Llama 3.2 1B, 16 mots d'avance | 10,84 (×2,3) | 18,65 (×4,0) | 19 % / 34 % |
Le brouillon de 1 milliard de paramètres rend le 70B 2,6 à 4 fois plus rapide : 12 tok/s en prose et jusqu'à 19 tok/s en code. Le gain dépend du texte. Sur trois textes de code, la vitesse va de 13,2 à 18,0 tok/s avec 8 mots d'avance. Le brouillon est plus souvent suivi sur le code (50 % de mots gardés) que sur la prose (33 %).
Nos textes sont en français pour la prose et en anglais pour le code ; d'autres textes donneront d'autres gains. Pour la prose, 8 mots d'avance donnent mieux que 16 (11,99 contre 10,84). Pour le code, 16 donnent un peu plus (18,65 contre 17,48), avec un écart entre textes du même ordre. Commencez par 8.
Le même principe existe sans second fichier quand le modèle porte son propre module de prédiction de plusieurs tokens (MTP). Avec Qwen3.8 27B et l'option --spec-type draft-mtp, llama.cpp passe de 11,71 à 21,48 tok/s en prose (×1,8) et de 11,59 à 27,23 tok/s en code (×2,3).
#Avec TensorRT-LLM : la recette Draft-Target de NVIDIA
TensorRT-LLM est la bibliothèque de NVIDIA pour servir les modèles de façon optimisée. Son guide pour DGX Spark propose la méthode Draft-Target : Llama 3.3 70B en FP4 est accompagné de Llama 3.1 8B en FP4 comme brouillon. Les deux modèles sont fournis par NVIDIA. Dans la version 1.3.0rc12 du conteneur, la valeur du réglage s'écrit Draft_Target, avec un tiret bas.
| Configuration | Prose française | Code |
|---|---|---|
| + brouillon Llama 3.1 8B FP4, 4 mots d'avance | 10,13 (×3,0 par rapport au même moteur sans brouillon) | 12,28 (×3,7) |
Avec TensorRT-LLM, le brouillon multiplie la vitesse par 3,0 en prose et par 3,7 en code, par rapport au même moteur sans brouillon : le 70B écrit alors 10,1 tokens par seconde en prose et 12,3 en code.
Les deux voies, llama.cpp et TensorRT-LLM, apportent donc un gain du même ordre, de 2,6 à 4 fois. Pour un seul utilisateur, llama.cpp reste la plus simple : un fichier de brouillon et quatre options. TensorRT-LLM est la voie à suivre si vous voulez la recette officielle de NVIDIA, avec des modèles FP4 fournis par NVIDIA.
#Le budget mémoire du contexte, de 8 192 à 131 072 tokens
Le contexte a un coût en mémoire : le cache KV. C'est la mémoire où le modèle garde ce qu'il a déjà lu, pour ne pas le recalculer. Il grossit avec la longueur du contexte. llama.cpp réserve tout ce cache dès le chargement, donc la mémoire occupée après le chargement est déjà la mémoire finale.
Nous la mesurons par la baisse de la mémoire disponible (MemAvailable de Linux), après avoir vidé le cache du disque. L'option -ctk q8_0 -ctv q8_0 range le cache sur 8 bits au lieu de 16 (f16), ce qui l'allège. Dans les tableaux et les graphiques, 8k désigne un contexte de 8 192 tokens, 32k de 32 768, 64k de 65 536 et 128k de 131 072.
| Modèle | Cache | 8 192 | 32 768 | 65 536 | 131 072 |
|---|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M | f16 | 43,6 | 51,3 | 61,4 | 81,9 |
| Llama 3.3 70B Q4_K_M | q8_0 | 42,3 | 46,4 | 52,2 | 63,1 |
| gpt-oss 120B MXFP4 | f16 | 61,0 | 61,9 | 63,0 | 65,6 |
| gpt-oss 120B MXFP4 | q8_0 | 60,7 | 61,3 | 62,1 | 63,2 |
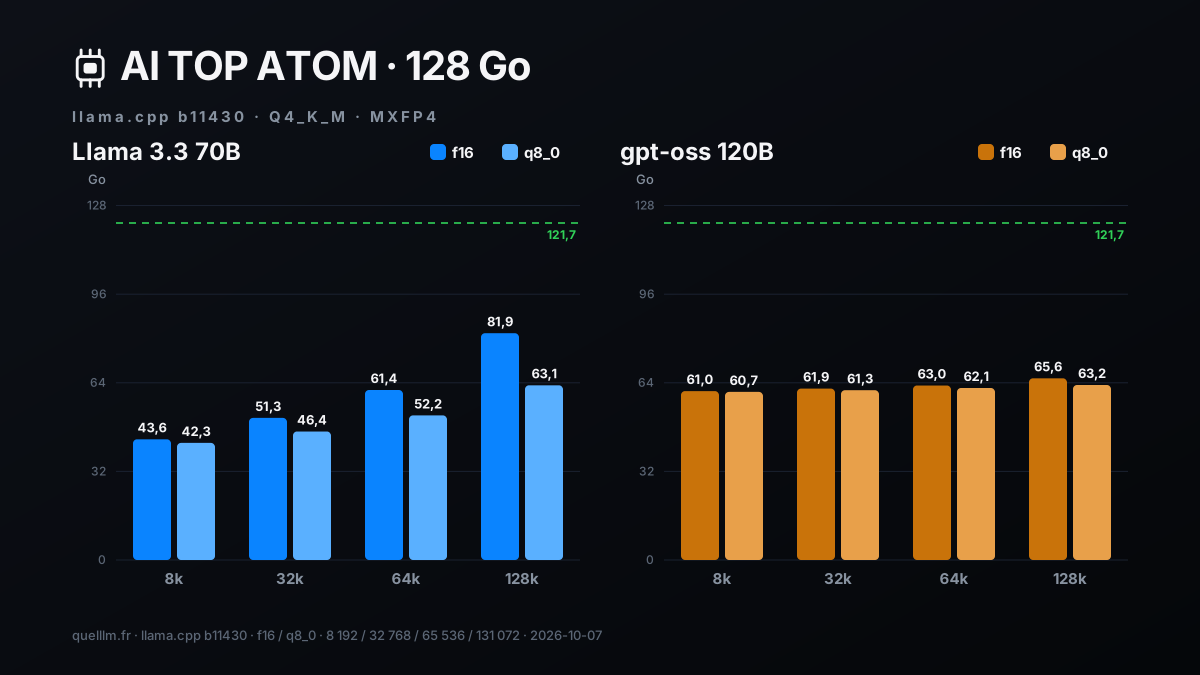
Tout tient dans les 121,7 Go, même le 70B avec un contexte de 131 072 tokens en f16 : 81,9 Go. Le contexte ajoute 38 Go au 70B entre 8k et 128k en f16, et 21 Go en q8_0, soit près de moitié moins. gpt-oss 120B n'ajoute que 4,6 Go : il alterne des couches qui regardent tout le texte et des couches qui n'en regardent qu'une fenêtre courte. Le format q8_0 se paie par une vitesse un peu plus basse, de 9 à 11 % à 128k pour le 70B (tableau suivant).
Nous avons aussi rempli le contexte à 90 % avec des fiches pratiques de Service-Public, pour mesurer la lecture et l'écriture à contexte plein. À 128k, le texte fait 117 605 tokens pour le 70B et 117 889 pour gpt-oss 120B, soit environ 200 pages.
| Modèle | Cache | Texte lu (tokens) | Mémoire (Go) | Lecture | Écriture |
|---|---|---|---|---|---|
| Llama 3.3 70B | f16 | 29 214 (32k) | 51,4 | 286,1 (102 s) | 4,22 |
| Llama 3.3 70B | q8_0 | 29 214 (32k) | 46,5 | 271,1 (108 s) | 4,02 |
| Llama 3.3 70B | f16 | 117 605 (128k) | 82,0 | 181,9 (646 s) | 2,86 |
| Llama 3.3 70B | q8_0 | 117 605 (128k) | 63,2 | 164,6 (715 s) | 2,54 |
| gpt-oss 120B | f16 | 29 227 (32k) | 61,7 | 1 443 (20 s) | 43,81 |
| gpt-oss 120B | q8_0 | 29 227 (32k) | 61,2 | 1 401 (21 s) | 43,96 |
| gpt-oss 120B | f16 | 117 889 (128k) | 65,4 | 1 073 (110 s) | 26,93 |
| gpt-oss 120B | q8_0 | 117 889 (128k) | 63,4 | 993 (119 s) | 24,97 |
Tout fonctionne à contexte plein. gpt-oss 120B lit un texte de 200 pages en 110 secondes et continue d'écrire à près de 27 tok/s. Le 70B lit les 117 605 tokens à 182 tok/s. Pour de très longs documents, un modèle MoE est plus rapide, en lecture comme en écriture.
#Deux heures de service à huit utilisateurs
Un serveur doit tenir dans la durée. Nous avons lancé vLLM 26.09 avec Llama 3.3 70B en NVFP4 et envoyé des requêtes pendant deux heures : huit utilisateurs en continu, des tranches de 32 requêtes de 1 024 tokens en entrée et 256 en sortie. Un relevé de la puce, à une mesure par seconde, a suivi la puissance, la fréquence et la température du GPU.
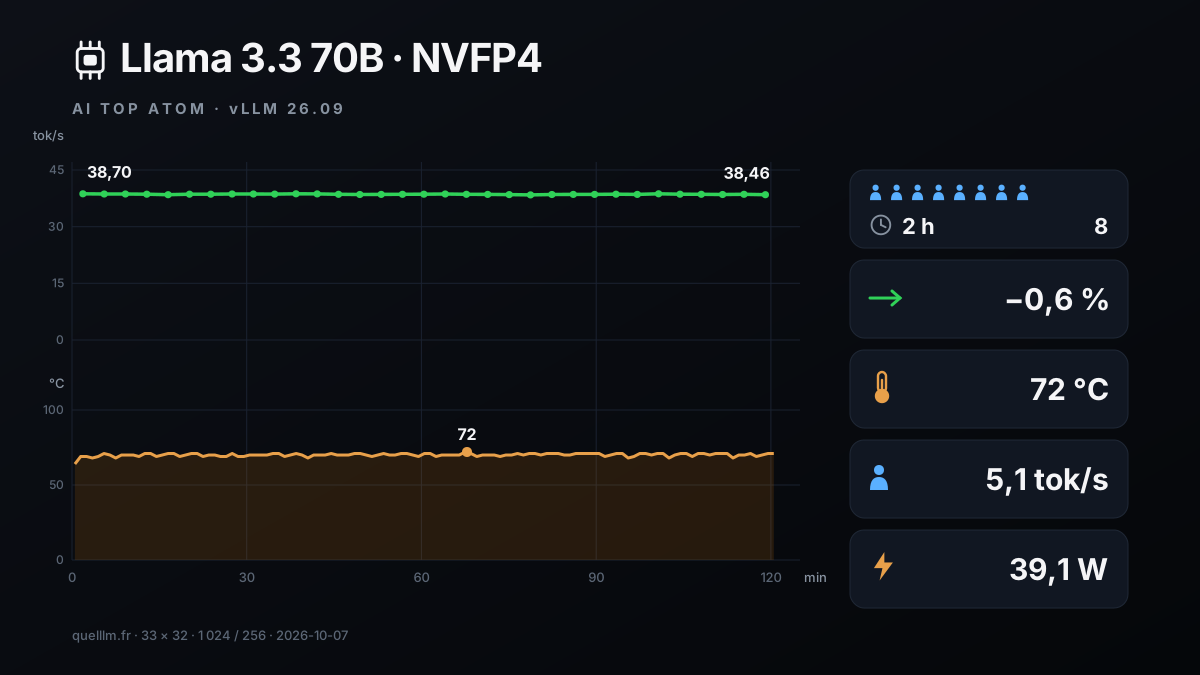
Le résultat est simple : la vitesse n'a pas bougé. Le débit total va de 38,70 tok/s dans la première tranche à 38,46 dans la dernière, avec un minimum de 38,40 et un maximum de 38,70 : l'écart est de −0,6 %. Chaque utilisateur reçoit 5,1 tok/s. Le premier mot arrive en 2,8 s en médiane, entre 2,4 et 2,9 s selon la tranche.
Au total, la machine a servi 1 056 requêtes, lu 1 081 344 tokens et écrit 270 336 tokens, sans aucune erreur. Le GPU est resté à 72 °C au plus. Sa fréquence médiane était de 2 528 MHz et aucune raison de bridage n'a été relevée pendant les deux heures de relevé.
La puissance moyenne du GPU était de 39,1 W, avec une pointe à 95,0 W. Ces watts sont ceux du GPU, lus par la puce : ils ne comptent ni le processeur, ni la mémoire, ni le SSD, ni l'alimentation. Les deux heures représentent 78,8 Wh pour le GPU, soit 1,6 centime au tarif EDF Tarif Bleu Base (6 kVA), à 20,01 centimes le kWh.
#En faire un serveur : API OpenAI, clé et Open WebUI
Une API OpenAI est un format de requêtes que de nombreux outils savent parler : éditeurs de code, interfaces de discussion, scripts. llama-server et vLLM l'offrent tous les deux. Pour la protéger, llama-server accepte une clé avec l'option --api-key : sans clé, il répond par une erreur 401. Nous avons validé ces trois appels avec gpt-oss 20B ; pour le 70B, c'est la même commande avec un autre fichier.
Le premier appel renvoie 401, le deuxième la liste des modèles servis, le troisième une réponse au format OpenAI. L'option --jinja applique le modèle de conversation fourni par le fichier du modèle.
Pour une interface de discussion, Open WebUI se branche sur cette API. Voici la pile de notre test d'assistant privé (un autre guide de la série), avec gpt-oss 120B. Le serveur de modèle est dans un réseau Docker interne, sans accès à Internet. Open WebUI 0.11.4 est relié à ce réseau et à un réseau d'accès.
Ainsi, le modèle n'a aucune sortie vers l'extérieur. Le serveur n'a pas de clé, car seul le réseau interne peut le joindre ; la valeur local d'OPENAI_API_KEY sert seulement à satisfaire Open WebUI. Pour servir le 70B à la place, remplacez le chemin du fichier par celui de Llama-3.3-70B-Instruct-Q4_K_M.gguf et adaptez -c et -np au budget mémoire vu plus haut.
Ouvrez ensuite http://127.0.0.1:3100 dans un navigateur de la machine : le modèle apparaît dans la liste. Dans notre test d'assistant privé, la pile complète, avec un serveur de plongements (bge-m3) en plus, était prête en 66 secondes. Selon le guide llama.cpp de NVIDIA, Open WebUI, Continue.dev et d'autres clients se branchent sur cette API, qui suit le format de l'API OpenAI (adresse du serveur suivie de /v1).
#L'alternative rapide : un modèle MoE de 120B
Un modèle MoE (mixture of experts) contient beaucoup de paramètres mais n'en utilise qu'une fraction à chaque token. gpt-oss 120B compte 117 milliards de paramètres dont 5,1 milliards actifs, et OpenAI le publie directement au format MXFP4.
Sur la GB10, il écrit à 58,0 tok/s avec l'outil de mesure llama-bench (écriture de 32 tokens), et à 54,4 tok/s en réponses longues sur llama-server, en prose comme en code. C'est plus de 11 fois la vitesse du 70B dense, avec une mémoire occupée de 61,0 Go à 8 192 tokens et de 65,6 Go à 131 072.
La vitesse ne dit rien de la qualité : nous n'avons pas comparé les réponses des deux modèles. Voici comment choisir. Prenez gpt-oss 120B pour la conversation, les agents et les longs documents, où la vitesse compte. Prenez Llama 3.3 70B si vous avez besoin de ce modèle précis, par exemple un modèle réglé à partir de lui, ou pour des traitements en lot où 5 tok/s suffisent. Les mesures des 13 modèles, du 4B au 235B, sont dans notre premier guide de la série.
#Ce que ce guide ne mesure pas
- La qualité des réponses
- Nous mesurons la vitesse et la mémoire, pas ce que vaut chaque modèle.
- Les gains du brouillon sur d'autres textes
- Nos six textes sont en français pour la prose et en anglais pour le code. Les gains dépendent du texte et de la langue.
- Les contextes au-delà de 131 072 tokens
- Nous n'avons mesuré ni leur mémoire ni leur vitesse.
- Les autres machines GB10 et la version 64 Go
- Nos mesures sur l'ATOM 128 Go rejoignent les références publiées pour le DGX Spark.
- La consommation de la machine entière
- Les watts donnés sont ceux du GPU, lus par la puce.
Mises à jour et corrections : cette page sera révisée si une nouvelle version de DGX OS, de llama.cpp, d'Ollama, de vLLM ou de TensorRT-LLM change ces résultats ; chaque correction sera datée.
#Pour qui l'ATOM est le bon choix
Ce qui suit vient de nos mesures sur l'ATOM, une machine GB10 de 128 Go.
- L'ATOM est le bon choix si vous voulez un modèle de 70 milliards de paramètres chez vous
- Il tient avec de la marge : de 43,6 à 82 Go sur 121,7 Go, avec un contexte de 8 192 à 131 072 tokens, et trois voies d'installation fonctionnent.
- … si plusieurs personnes ou agents partagent le modèle
- Huit utilisateurs obtiennent 37,7 tok/s au total sur une série courte, et 38,6 tok/s en moyenne pendant deux heures, sans aucune erreur.
- … si vous voulez aller plus vite sans changer de machine
- Un petit brouillon multiplie la vitesse du 70B par 2,6 à 4, avec llama.cpp ou avec la recette de NVIDIA.
- … si vous voulez une conversation rapide ou de longs documents
- gpt-oss 120B écrit à 54,4 tok/s et lit 200 pages en 110 secondes.
- … si votre travail passe par l'écosystème NVIDIA
- CUDA 13, vLLM et TensorRT-LLM dans les conteneurs de NVIDIA et llama.cpp compilé pour la GB10 ont fonctionné chez nous sous DGX OS 7.5.0.
Côté GIGABYTE, le châssis d'environ un litre a gardé le GPU à 72 °C au plus pendant deux heures de charge continue, sans bridage. Les prix des machines GB10 bougent chaque semaine : vérifiez-les sur la fiche de la machine avant d'acheter.
#FAQ
Peut-on faire tourner un modèle 70B sur une machine GB10 de 128 Go ?+
À quelle vitesse écrit un 70B sur l'AI TOP ATOM ?+
Faut-il choisir Ollama, llama.cpp ou vLLM ?+
Comment rendre un 70B plus rapide sans changer de machine ?+
Un 70B peut-il servir plusieurs personnes pendant des heures ?+
Vaut-il mieux un modèle MoE de 120B qu'un 70B dense ?+
Un retour, une erreur, une précision ? Faites-nous signe, ça améliore le guide pour tout le monde.